专题深读 · 2026-10-28 · 基础 · 作者 bombong
幻觉(Hallucination):为何产生,如何减少
幻觉是语言模型说出看似合理但错误内容的现象。一种日益受到认可的解释是:训练和评估奖励“猜测”而非“不知道”,因此产生了幻觉。本文梳理其成因、检测与缓解技术、近期研究动向,以及在实践中选择技术时需要考虑的要点。
- 幻觉并不是奇怪的 bug,而是从无法区分事实与错误的分类错误中统计性地产生的;只对正确答案计分的评估会助长“猜测”。
- 幻觉的性质因任务而异。事实性问题在模型内部较容易区分,但在摘要或常见误解较多的问题中,正确答案与幻觉相互交织。
- 应对幻觉的方法大致有三类:成因侧(改变评分与奖励)、生成侧(RAG、投票、内部引导)和事后侧(检测与验证)。
- 近期研究正在向两个方向拓展:设计让置信度与正确性相吻合的奖励,以及在执行前阻止智能体的工具调用幻觉。
- 检测分数会因基准对幻觉的定义方式而大幅变化。不能只看一个数字就比较各项技术。
为什么是问题:看似合理却出错的模型
幻觉(Hallucination)是大语言模型(LLM)输出流畅但与事实不符内容的现象。由于语法和语气都没有问题,读者很难察觉错误。因此,这不只是性能问题,而是信任问题。“Why Language Models Hallucinate(paper)”指出,即使在最新系统中,幻觉也没有消失,并且会削弱信任。
人们通常期望,只要扩大模型、增加数据,幻觉就会自然减少。然而,神经多样性研究(paper)的出发点是:即使参数、计算量和数据不断增加,语言模型仍会持续产生幻觉。这意味着存在仅靠扩大规模无法解决的结构性原因。
检索外部文档并将其作为依据附上的 RAG(检索增强生成)也不是完整的解决方案。VOTE-RAG(paper)解释说,如果检索结果本身有误,生成模型就会被其带偏,错误层层叠加,形成“幻觉之上的幻觉”。即使附上依据,依据本身也可能是错的,这正是这一主题的难点所在。
核心思想:考试中猜答案的学生
“Why Language Models Hallucinate(paper)”用的比喻是面对难题的考生。交白卷得 0 分,猜一个答案却有可能猜对。所以,即使不会,写一个看似合理的答案也对分数更有利。该论文认为语言模型也处于同样的处境:没有把握时,与其说“不知道”,不如猜一个看似合理的答案。
这一解释分为两个层面。第一,在预训练阶段,幻觉并不是神秘现象,而是源于二分类(判断对/错的问题)的错误。如果无法区分错误陈述与事实,仅凭自然的统计压力就会产生幻觉。第二,大多数评估只按是否正确计分。因此,模型被优化为“擅长考试”的一方,也就是在不确定时去猜。
从这一视角出发,对策也随之不同。该论文认为,再多做一个专门针对幻觉的评估是不够的。它主张应当修改主导排行榜的现有基准的计分方式,也就是惩罚不确定回答的方式,并称之为需要技术与社会共同解决的缓解措施。这一视角的核心在于:“为什么会这样设计”这个问题的答案,不在模型结构,而在评估制度。
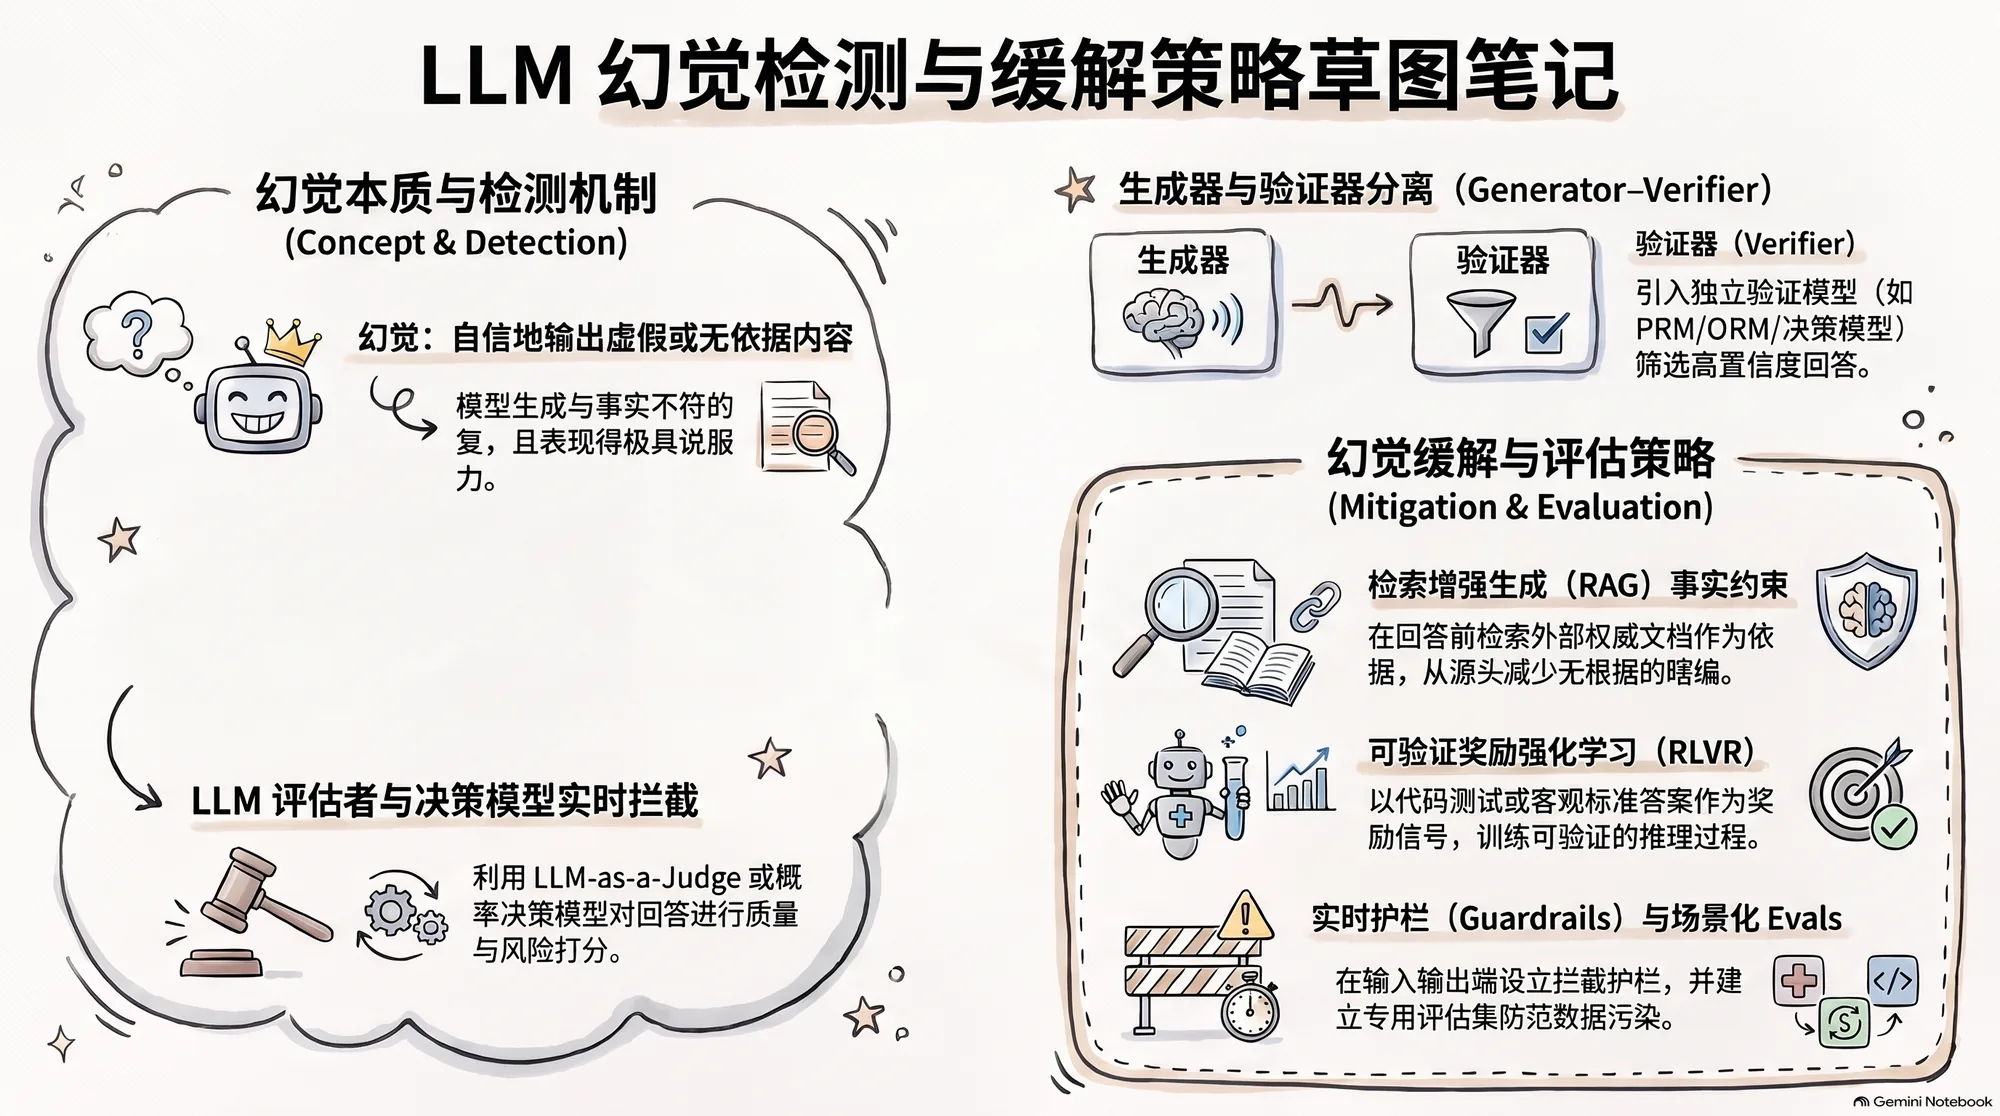
如何产生,在哪里拦截
把幻觉产生的路径分成几个阶段,就能看清应对的切入点。① 在预训练中通过预测下一个 token 学习统计规律时,难以区分的事实会作为错误残留下来。② 在评估与奖励阶段,如果只对正确答案计分,猜测就会得到奖励。③ 在生成答案的那一刻,模型内部状态会决定走向正确答案还是走向幻觉。④ 输出产生后,可以通过检测与验证进行过滤。
深入研究第 ③ 阶段的是“Hallucination Basins(paper)”。该研究分析模型逐个生成 token 时所经过的隐藏表示(Hidden Representation)轨迹(Trajectory),认为潜在空间(模型内部的数值空间)中存在因任务而异的“盆地(basin)”,即会把状态吸入其中的凹陷区域。在事实性问题中,正确答案与幻觉的盆地分得比较清楚,但在摘要或常见误解较多的问题中,两者经常重叠。该研究报告称,利用这种几何结构稍微调整生成方向(引导),无需重新训练就能降低幻觉概率。
第 ④ 阶段的检测有多种方法。OOD 视角研究(paper)把下一个 token 预测视为分类问题,将计算机视觉中使用的分布外(OOD,训练时未见过的类型的输入)检测技术改造后应用于语言模型。由此得到了一个无需训练、仅凭单个样本即可判断的检测器,在推理任务上也有较高准确率。小模型验证研究(paper)把答案拆分为句子,然后汇总多个 SLM(小型语言模型)在参考检索到的上下文后回答“Yes”的概率,判断每个句子是否与依据相符。
也有方法在生成阶段就让模型少出错。VOTE-RAG(paper)设置了两个阶段:由多个智能体用不同检索词收集文档的“检索投票”,以及由多个智能体独立作答后以多数决定答案的“回答投票”。它无需单独训练,所有过程都可以并行运行。
发展脉络:成因、检测、缓解三条路线
本资料所依据的几篇论文与其说是一条传承脉络,不如说是在同一时期沿三条路线并行推进。第一条路线是成因解释。“Why Language Models Hallucinate(paper)”用统计和评估制度解释幻觉,“Hallucination Basins(paper)”则用模型内部的几何结构加以解释,并指出不同任务的可区分程度不同。
第二条路线是检测。小模型验证研究(paper)用 100 余组问题、答案和上下文进行实验,报告称区分正确回答与幻觉的 F1 分数(精确率与召回率的调和平均)提高了 10%。幻觉分类框架(paper)通过提示工程有意复现多种类型的幻觉,并在嵌入空间中进行聚类分析。结果发现,信息扭曲越严重的幻觉离正确答案簇越远,并认为用简单的分类器也能区分两者。OOD 视角研究(paper)把检测范围扩展到了现有检测器表现较弱的推理任务。
第三条路线是缓解。VOTE-RAG(paper)在 6 个基准上取得了与更复杂框架相当或更好的性能。由于投票结构简单,它也避开了问题被带向其他方向的“问题漂移”风险。神经多样性研究(paper)提出“神经多样性”,即让并行设置的各个表示(Representation)彼此不那么相似。实现这一思路的 ND-LoRA(在并行 LoRA 适配器上结合降低相关性的正则化)在保持通用准确率的同时,将幻觉最多减少 25.6%,平均减少 14.6%。该研究还报告了神经相关性每增加 0.1%、幻觉增加 3.8% 的关联,并将其称为独立于参数和数据的“第三条扩展(scaling)轴”。
近期走向
第一个趋势是把“不要奖励猜测”这一诊断直接纳入训练奖励。CalibraRL(paper)指出,对正确答案给予奖励、对错误答案施加惩罚并允许弃答(不作回答)的强化学习已经在使用,但固定奖励无法区分自信的错误答案和犹豫的错误答案。因此,在作答时,置信度与正确性偏离越大,惩罚越重;在弃答时,则估计模型在该问题上能多可靠地作答,据此确定奖励。由于复用训练中已生成的 rollout,不需要关于“模型是否知道这个答案”的额外标注。该研究报告称,在三个 QA 数据集上提高了答案精确率并减少了幻觉。
第二个趋势是幻觉的范围从文本扩展到了行动。StateMirror(paper)把编码智能体调用不存在的路径或未安装的包称为“幻觉式工具使用”。对 4,398 条智能体轨迹(Trajectory)的调查显示,这类幻觉很常见,恢复所需的额外交互中位数为 3 次,token 中位数为 2.24 万(22.4K)个。StateMirror 在 Harness 边界拦截行动,并在执行前将其与实际代码仓库状态进行确定性比对。在 2,508 个行动上,它取得了 0.940 的精确率和 0.817 的 F1,F1 比最强的 LLM 评估器高 35.3%。检测延迟的中位数从 17.73 秒降至 1.50ms,且不消耗 token。借助执行前获得的反馈,智能体自行修正了 95% 以上的幻觉式工具调用。
第三个趋势是“如何信任检测分数”这一测量问题。Mycelium(paper)指出,各基准定义和测量幻觉的方式差异很大,分数之间难以比较。因此,它按三个维度整理基准:来源(输出和依据如何获得)、类型(是事实性失败还是依据忠实性失败)、粒度(在什么范围内标注和评估)。它还表明,在片段级评估中,标注边界只要稍有不同,分数就会大幅波动。
StateMirror 的执行前检查
局限与实践判断标准
最常见的错误是认为“接上了 RAG,幻觉就解决了”。正如 VOTE-RAG(paper)所指出的,错误的检索结果反而会加剧幻觉。更稳妥的做法是单独检查检索质量,同时配备让检索词多样化或比较多个答案的机制。
第二,不同任务上各种方法的效果不同。根据“Hallucination Basins(paper)”,在事实类问题上容易用内部信号区分幻觉,但在摘要或混有错误概念的问题上,正确答案与幻觉会相互重叠。神经多样性研究(paper)也报告称,每项任务适合的多样性程度不同。不能假设在演示用的事实类问题上表现良好的检测器,在摘要业务中也同样有效。
第三,不要直接比较检测性能数字。正如 Mycelium(paper)所展示的,即便同样是“幻觉检测 F1”,其含义也取决于基准把什么视为幻觉。引入之前,应先确定在自己的业务数据中以什么单位(句子、片段、整个回答)和类型来界定“幻觉”,再按这一标准重新测量。
第四,弃答与准确率是此消彼长的关系。允许“不知道就说不知道”可以减少幻觉,但过度时无用的弃答会增多。这正是 CalibraRL(paper)根据每个问题的置信度调节弃答奖励的原因。实际工作中也应同时关注弃答率和错误率,并事先确定服务更不能接受“错误答案”还是“没有答案”。下表按是否需要重新训练、是否需要外部依据、是否需要访问模型内部,对本文涉及的方法进行了分类。如果只通过 API 使用模型,从不需要访问模型内部的方法开始考察更为现实。
选择幻觉应对方法
| 无需重新训练 | 需要外部依据 | 访问模型内部 | |
|---|---|---|---|
| VOTE-RAG | ✓ | ✓ | ✕ |
| SLM 验证 | ✓ | ✓ | ✕ |
| OOD 检测 | ✓ | ✕ | ✓ |
| 盆地引导 | ✓ | ✕ | ✓ |
| ND-LoRA | ✕ | ✕ | ✓ |
| CalibraRL | ✕ | ✕ | ✓ |
| StateMirror | ✓ | ✕ | ✕ |
延伸阅读
如果是初次接触,建议先读“Why Language Models Hallucinate(paper)”。先建立把幻觉看作分类错误与评估机制问题的视角,就更容易理清其他论文针对的是哪个环节。如果想整体浏览一遍,简要总结幻觉的类型、成因和缓解方法的综述(paper)适合入门。
如果想了解模型内部发生了什么,可以接着读“Hallucination Basins(paper)”和 OOD 视角的研究(paper)。如果在运营 RAG 服务,VOTE-RAG(paper)和小型模型验证研究(paper)展示了可以直接应用的免训练方法。
最新动向读三篇就足够了:奖励设计方面读 CalibraRL(paper),智能体方面读 StateMirror(paper),评估方法论方面读 Mycelium(paper)。尤其是 Mycelium 讲解了如何解读其他检测论文中的数字,因此在比较、引入方法之前先读它会有帮助。
相关术语
参考资料
奠基论文
- Why Language Models Hallucinate (2025)
- Hallucination Basins: A Dynamic Framework for Understanding and Controlling LLM Hallucinations (2026)
- From Out-of-Distribution Detection to Hallucination Detection: A Geometric View (2026)
- Hallucination Detection with Small Language Models (2025)
- A novel hallucination classification framework (2025)
- Mitigating Hallucination on Hallucination in RAG via Ensemble Voting (2026)
- Neural Diversity Regularizes Hallucinations in Language Models (2025)
最新研究
由 AI 根据所列参考资料撰写并经过审核。详情请查看原始资料。