专题深读 · 2026-10-21 · 进阶
上下文工程:超越提示词,放入什么、放入多少
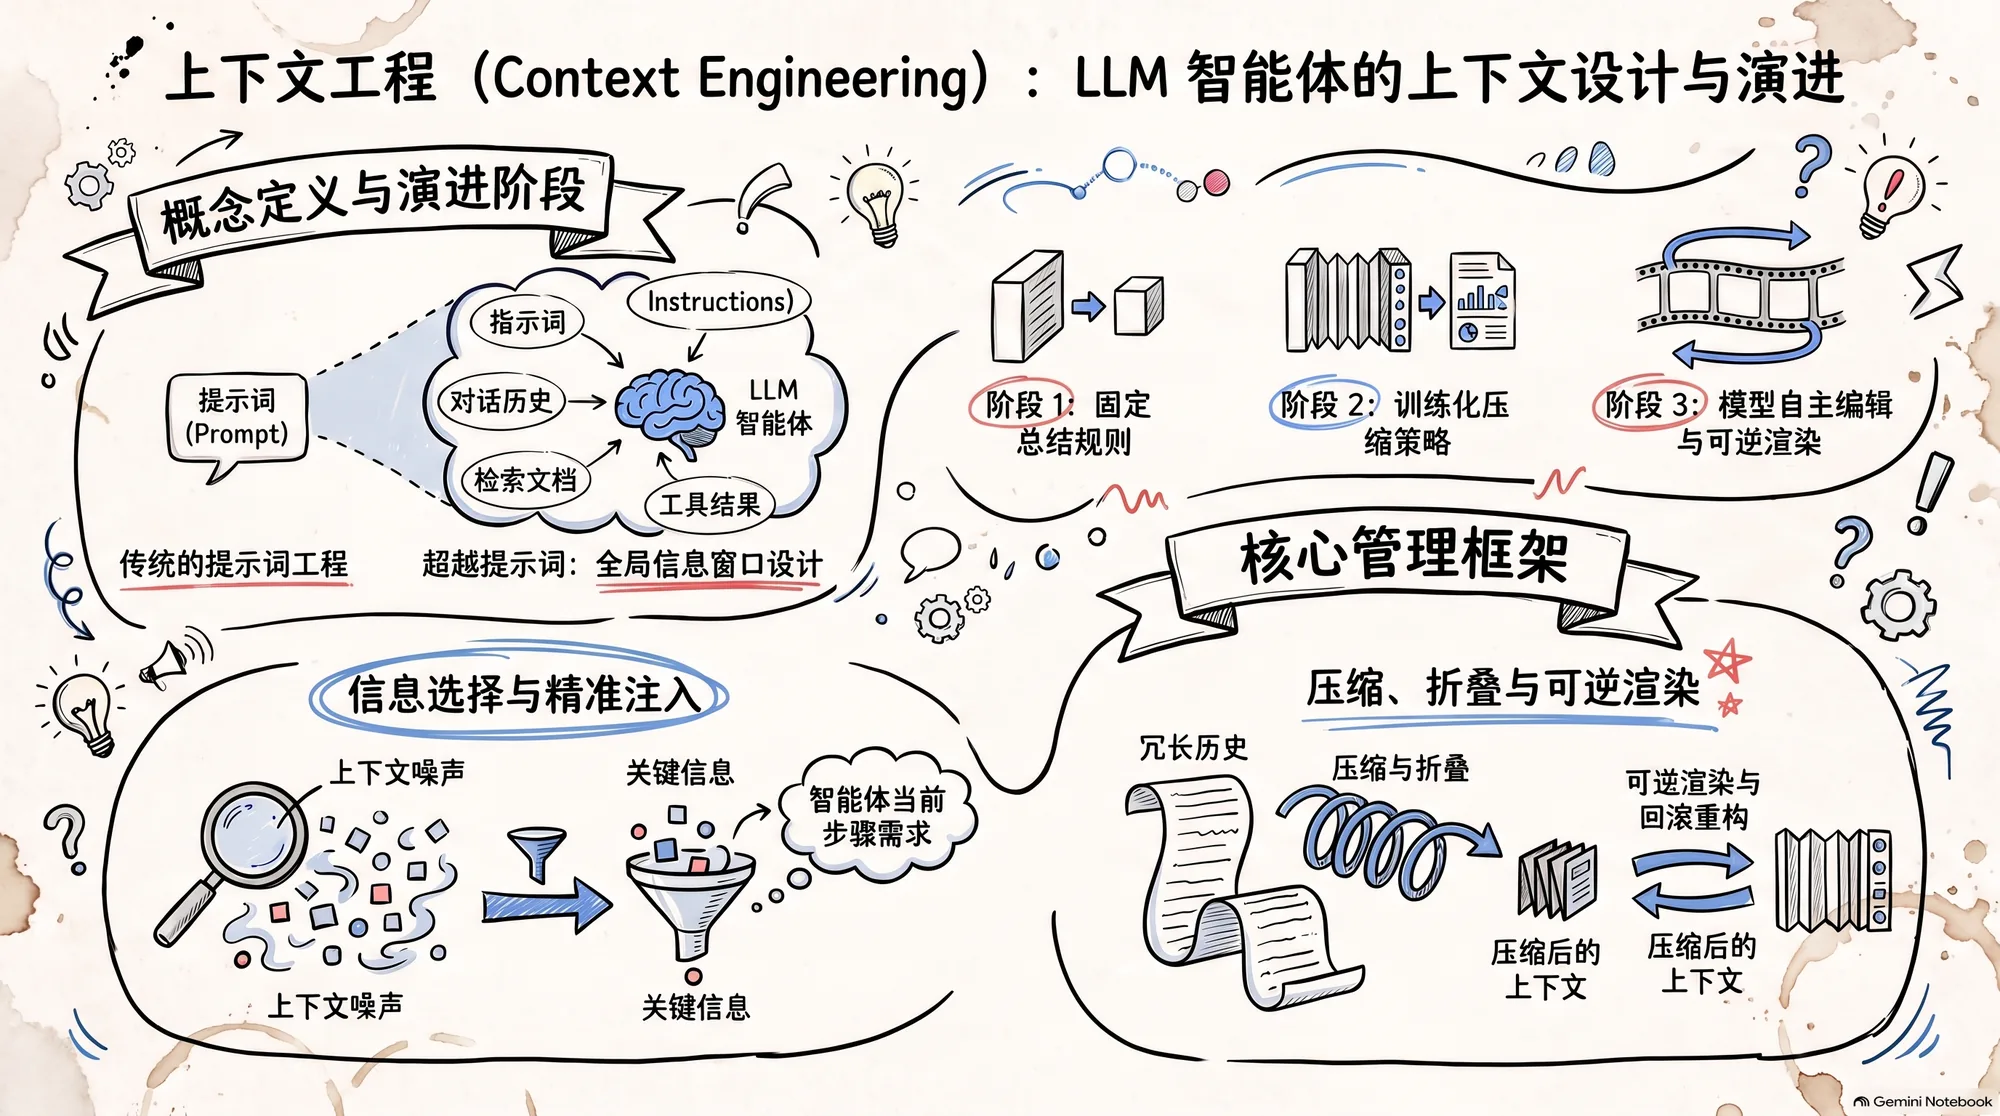
上下文工程是一种设计方法,用于让执行长任务的智能体在每一步决定向模型展示什么、展示多少,并对内容进行筛选、缩减、折叠和恢复。研究从固定的摘要规则出发,正逐步转向学习得到的压缩与折叠策略、可逆渲染,以及由模型自行编辑上下文的方式。
- 在长任务中如果只是不断追加历史,上下文会溢出、噪声会累积、成本会上升,推理质量也会下降。
- 核心问题是“这条信息在下一步是否会被用到”,各项研究通过摘要、折叠、卡片替换和剪枝来实现这一判断。
- 随着“随情况变化的策略优于固定规则”的结果不断出现,出现了一股把上下文管理提升为工具、学习对象和模型自身能力的趋势。
- 错误删除的信息难以恢复,提示缓存也可能失效,因此保留原始内容的可逆设计受到关注。
- 同一种技术会因智能体的行为倾向不同而有利或有害,因此需要观察实际行为后再选择使用。
为什么需要:只增不减的上下文
如果说提示工程关注的是“如何写好一次请求”,那么上下文工程(Context engineering)关注的是“在多个步骤中如何组织模型看到的全部信息”。需要数十次搜索网页、或在代码仓库中来回修改的 AI 智能体,每一步都会累积工具结果、观察和思考。许多智能体只是把这些历史追加到末尾(append-only),并在每一步把全部内容重新发送给模型。ReFold(paper)指出,正因如此,随着步骤增加,上下文和成本会一起增长,最终超出上下文窗口(模型一次能读取的最大长度)。
问题不只在于长度。分析长程网页搜索智能体的 SLIM 研究(paper)将以下几点列为失败的主要原因:现有框架不断累积冗长且噪声多的内容,进而触及上下文窗口或工具调用上限,或者过早停止。研究软件开发智能体的 CAT(paper)解释说,这种只追加或被动压缩的方式会导致上下文膨胀、语义逐渐偏离(semantic drift)以及推理质量下降。
此外还有模型容易遗漏中间位置信息的“lost-in-the-middle”现象。ContextCurator 研究(paper)认为,冗长的环境输出所累积的噪声会在多轮交互中干扰推理。归根结底,即使上下文窗口足够大,“放得越多越好”的假设也不成立。放入什么、缩减什么、去掉什么,成了一个设计问题。
核心思想:行李要轻,所需之物要能取出
想想长途旅行打包行李就容易理解。如果把一路上的收据都带在身上,包会越来越重,真正需要的东西反而难找。但如果随便扔东西,又可能丢掉以后必需的文件。好的旅行者只把“下一段行程要用的东西”放进包里,其余寄存在住处的保险箱,需要时再取出。CarryOn(paper)使用“Pack Light”这一说法,也是出于同样的直觉。
上下文工程的判断标准同样是“未来会被用到的价值”。PAACE(paper)根据与接下来若干任务的相关性(next-k-task relevance)以及计划结构来决定压缩什么。CAT(paper)把工作空间分为三部分:不变的任务目标、压缩后的长期记忆,以及保持原样的近期交互。这是一种缩减旧内容、保留近期内容原貌的结构。
因此,上下文工程与其说是“写好”提示词的技术,不如说更接近“分配好”有限空间的技术。空间是固定的,任务目标、记忆、近期记录和工具说明都在争夺这块空间。
分配有限的上下文
上下文窗口
任务目标压缩后的长期记忆近期交互只增不减的旧记录
如何运作:判断、缩减、再展示
把多项研究叠在一起看,可以看到一个共同的循环。第一,智能体行动和观察的结果累积到历史中。第二,在既定时刻(固定间隔、里程碑、超出预算时)判断保留什么。第三,对不保留的部分进行摘要、折叠为一行备注,或替换为简短卡片。第四,把整理后的上下文展示给模型,获取下一步行动。然后重复这个循环。
具体方法因研究而异。SLIM(paper)把搜索和页面阅读拆分为不同工具,并定期对轨迹(迄今为止的行动记录)进行摘要。Context-Folding(paper)在处理子任务时会开出一个分支来执行,结束后折叠中间步骤,只保留结果摘要。CADOC(paper)把结构化对象替换为简短的检索用卡片,同时保留原始内容,以便需要时能准确取回。
在实际工具中,这个循环被纳入更大的 Harness(Agent Harness,包裹模型并接入工具、记忆和规则的执行框架)之中。终端编码智能体 OPENDEV(paper)同时使用:逐步缩减旧观察的自适应压缩、仅在需要时查找并接入工具的延迟工具发现、跨会话积累项目知识的自动记忆,以及防止指令被推到对话后方而逐渐淡化(instruction fade-out)的事件驱动系统提醒。把负责规划和负责执行的智能体分开,也是让各自上下文保持轻量的一种方法。
发展脉络:从固定规则到学习得到的策略
2025 年下半年的研究把“何时、如何做摘要”做得更加精细。SLIM(paper)仅凭简单的结构,在基于 o3 的设置下取得 BrowseComp 56%、HLE 33% 的成绩,分别比开源框架高 8 分和 6 分,工具调用次数少 4~6 倍。Context-Folding(paper)用强化学习(FoldGRPO)训练折叠行为,以小 10 倍的活跃上下文取得了与基于 ReAct 的智能体相当或更好的性能,并大幅领先基于摘要的管理方式。PAACE(paper)从教师模型的成功示范中蒸馏出考虑计划的压缩模型,在提高准确率的同时缩短了最大上下文长度。CAT(paper)把上下文管理做成智能体可以直接调用的“工具”,以此训练的 SWE-Compressor 在 SWE-Bench-Verified 上解决了 57.6% 的问题。
进入 2026 年,“不把一种策略坚持到底”的方向变得明确。AgentSwing(paper)认为固定策略在某些状态下合适、在另一些状态下不合适,因此在每个切换点并行展开多种管理方式,然后向前预判,选择最有希望的分支。结果是以最多少 3 倍的对话轮数取得了与固定方式相当或更好的性能。ContextCurator(paper)把管理与执行分离:由经强化学习训练的轻量策展模型剔除噪声,由固定的大模型执行任务。在 WebArena 上,它把 Gemini-3.0-flash 的成功率从 36.4% 提高到 41.2%,同时把 token 从 47.4K 减少到 43.3K,且 7B 策展模型达到了 GPT-4o 水平的管理性能。
ContextEvo(paper)更进一步,让管理策略本身进化。它在关键决策点还原模型实际看到的上下文,找出由上下文导致的失败并修正策略。它以开源的 Pi-agent Harness 为起点,在三个长程任务基准上取得了与 Codex、OpenCode 等 Harness 相当或更好的结果。这一脉络可以概括为“人工制定的摘要规则 → 学习得到的压缩与折叠 → 随环境变化的管理策略”。
最新方向:可逆、内化到模型、匹配行为
第一个方向是“可逆的管理”。ReFold(paper)不需要预测模型或训练,只在渲染层工作。它保持原始历史不变,只在展示给模型时进行压缩。已经在前面展示过的内容被替换为简短标记(stub),智能体声明已完成的轮次被折叠为一行备注。这样删除的内容可以从历史中一步恢复。此外,它不是每一步都改写,而是每隔几步集中改写一次,从而减少提示缓存(复用前缀相同请求的计算的技术)失效。在五个基准上,它在不降低成功率的情况下把 token 最多减少 2.5 倍,并把每个会话的 KV 缓存内存减半。
第二个方向是把编辑放进模型内部,而不是放在 Harness 外部。NCE(paper)把上下文编辑操作做成专用特殊 token 的“语法”,训练模型在生成回答的过程中直接用语言本身修改自己的上下文。其主张是,这比学习特定 Harness 的工具调用代码更能泛化到多种任务。在 Terminal-Bench 2.0 和 SWE-bench 系列共四个基准上,相比基础模型,LongCat-Flash-Lite-Sparse 的平均成功率提高 5.6 个百分点,Qwen3.6-35B-A3B 提高 4.5 个百分点,token 使用量分别减少 36% 和 15%。
第三个方向是追问“技术适合谁”的行为研究。一项关于数据智能体的研究(paper)用 7 个 LLM 和 1,514 个长程任务测试了语义层(描述数据的层)、把工作分给多个智能体的编排,以及历史压缩(compaction)。智能体分为仔细调查型、不看数据就匆忙作答型和过早放弃型,每种技术只在匹配的类型上转化为准确率提升。对仔细调查型反而有害:语义层让它们停止直接查看数据,编排引发过度自信导致损失 5 个百分点,压缩则让它们重复相同步骤。多种技术组合后的效果也小于各自效果之和。
局限与争议
最大的风险是错误删除。ReFold(paper)批评现有的预测式方法会因额外的模型调用增加执行负担、使提示缓存失效,并且无法保证恢复已删除的内容。也有观察表明,压缩首先损害的不是“能否答对”,而是“能否每次稳定答对”。PAIR(paper)对同一状态下压缩与不压缩的情况进行配对比较,发现严重的性能下降集中在少数几个具体的压缩时间点。
何时遗忘取决于时机。RECAP(paper)报告了这样的案例:面对相同的失败记录和相同的摘要,早期压缩导致失败,而晚期压缩则节省了成本。也就是说,很难给“这条信息重要或不重要”贴上固定标签。正如前面的数据智能体研究(paper)所示,效果可能因智能体倾向而反转,因此照搬别人认为好的技术可能会吃亏。
解读数据时也需要谨慎。本文中的性能和 token 数据都来自特定基准与特定模型的组合,且各研究的基准和比较对象各不相同。不能保证在实际服务环境中获得同样的收益。此外还存在权衡:基于学习的方法需要单独训练模型,渲染方式虽然无需训练,但判断较为简单。
删除方式与可逆方式
预测式管理额外模型·规则·学习策略
- 额外模型调用带来执行负担
- 提示缓存可能失效
- 无法保证恢复已删除内容
可逆渲染ReFold·CADOC 方式
- 原始历史保持不变
- 每隔几步集中改写以复用缓存
- 误删后可一步恢复
공통 两者的目标都是缩减展示给模型的上下文
延伸学习
如果是初次接触,建议从 SLIM(paper)读起。它通过错误分类说明长程搜索智能体为何因上下文而失败,解法也很简单,便于把握问题意识。接下来如果想了解实际工具的设计思路,可以读 OPENDEV(paper),从中可以看到压缩、记忆、系统提醒和工具延迟加载如何在一个 Harness 中相互配合。
如果对基于学习的方法感兴趣,可以把 Context-Folding(paper)和 CAT(paper)一起读:前者用强化学习训练折叠,后者把上下文管理作为工具调用来训练。AgentSwing(paper)和 ContextEvo(paper)很好地展示了根据情况调整管理策略的视角。
对于最新趋势,可以通过 ReFold(paper)了解可逆设计与缓存问题,通过 NCE(paper)了解作为模型自身能力的编辑,通过数据智能体行为研究(paper)了解“选择技术的标准”。相关术语方面,先熟悉上下文窗口、提示缓存、Harness 和智能体记忆,阅读会更顺畅。
相关术语
参考资料
奠基论文
- Lost in the Maze: Overcoming Context Limitations in Long-Horizon Agentic Search (2025)
- Scaling Long-Horizon LLM Agent via Context-Folding (2025)
- PAACE: A Plan-Aware Automated Agent Context Engineering Framework (2025)
- Context as a Tool: Context Management for Long-Horizon SWE-Agents (2025)
- Building Effective AI Coding Agents for the Terminal: Scaffolding, Harness, Context Engineering, and Lessons Learned (2026)
- AgentSwing: Adaptive Parallel Context Management Routing for Long-Horizon Web Agents (2026)
- Escaping the Context Bottleneck: Active Context Curation for LLM Agents via Reinforcement Learning (2026)
- Beyond Skill Evolution: Self-Evolving Context Management Policies for Long-Horizon Agent Harnesses (2026)
最新研究
由 AI 根据所列参考资料撰写并经过审核。详情请查看原始资料。