주제 탐구 · 2026-10-21 · 심화
컨텍스트 엔지니어링: 프롬프트를 넘어 무엇을 얼마나 넣을까
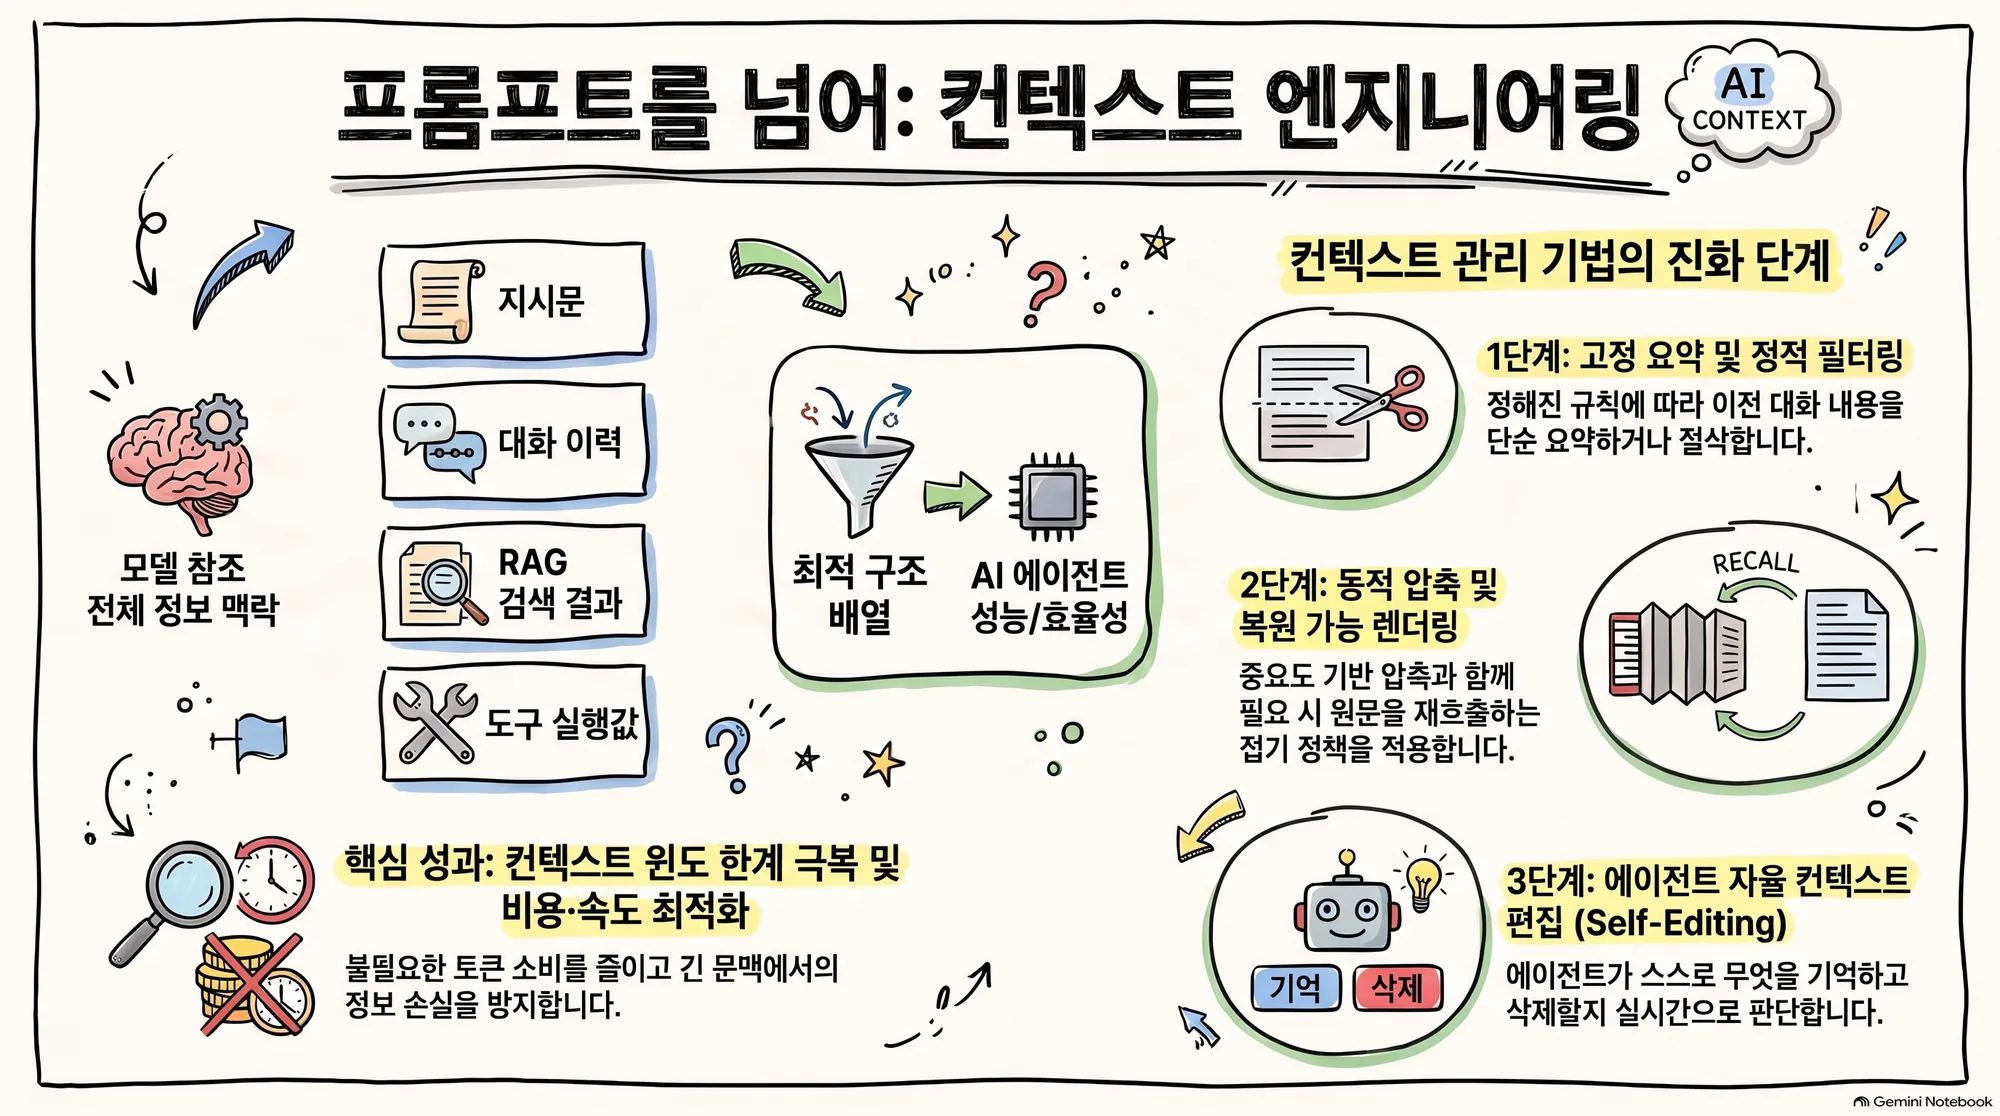
컨텍스트 엔지니어링은 긴 작업을 하는 에이전트가 매 단계 모델에 무엇을 얼마나 보여 줄지 고르고, 줄이고, 접고, 되돌리는 설계다. 연구는 고정된 요약 규칙에서 출발해 학습된 압축·접기 정책, 되돌릴 수 있는 렌더링, 모델이 스스로 편집하는 방식으로 옮겨 가고 있다.
목차
- 긴 작업에서 이력을 계속 덧붙이기만 하면 컨텍스트가 넘치고, 잡음이 쌓이며, 비용이 커지고 추론 품질도 떨어진다.
- 핵심 질문은 '이 정보가 다음 단계에 쓰이는가'이며, 연구들은 요약·접기·카드 치환·가지치기로 이 판단을 구현한다.
- 고정 규칙보다 상황에 따라 바뀌는 정책이 낫다는 결과가 이어지면서, 컨텍스트 관리를 도구·학습 대상·모델 고유 능력으로 끌어올리는 흐름이 생겼다.
- 잘못 지운 정보는 되살리기 어렵고 프롬프트 캐시도 깨질 수 있어, 원본을 보존하는 되돌릴 수 있는 설계가 주목받는다.
- 같은 기법도 에이전트의 행동 성향에 따라 득이 되기도 하고 해가 되기도 하므로, 실제 행동을 관찰하고 골라 써야 한다.
왜 필요했나: 쌓이기만 하는 컨텍스트
프롬프트 엔지니어링이 '한 번의 요청을 어떻게 잘 쓸까'에 집중했다면, 컨텍스트 엔지니어링(Context engineering)은 '여러 단계를 거치는 동안 모델이 보는 정보 전체를 어떻게 꾸릴까'를 다룬다. 웹을 수십 번 검색하거나 코드 저장소를 오가며 고치는 AI 에이전트는 단계마다 도구 결과·관찰·생각이 쌓인다. 많은 에이전트는 이 이력을 뒤에 덧붙이기만 하고(append-only), 매 단계 모델에 전부 다시 보낸다. ReFold논문는 이 때문에 단계가 늘수록 컨텍스트와 비용이 함께 커지다가 결국 컨텍스트 윈도(모델이 한 번에 읽을 수 있는 최대 길이)를 넘는다고 지적한다.
문제는 길이만이 아니다. 장기 웹 검색 에이전트를 분석한 SLIM 연구논문는 기존 프레임워크가 길고 잡음 많은 내용을 쌓다가 컨텍스트 윈도나 도구 호출 한도에 걸리거나, 너무 일찍 멈춘다는 점을 실패의 주원인으로 꼽았다. 소프트웨어 개발 에이전트를 다룬 CAT논문는 이렇게 덧붙이기만 하거나 수동적으로 압축하는 방식이 컨텍스트 폭발, 의미가 점점 엇나가는 현상(semantic drift), 추론 품질 저하로 이어진다고 설명한다.
중간에 놓인 정보를 모델이 잘 놓치는 'lost-in-the-middle' 현상도 있다. ContextCurator 연구논문는 장황한 환경 출력에서 쌓인 잡음이 여러 차례 주고받는 동안 추론을 흐린다고 본다. 결국 컨텍스트 윈도가 넉넉해도 '많이 넣을수록 좋다'는 가정은 성립하지 않는다. 무엇을 넣고, 무엇을 줄이고, 무엇을 빼야 하는지가 설계 문제가 된다.
핵심 아이디어: 짐은 가볍게, 필요한 것은 꺼낼 수 있게
긴 여행의 짐 싸기를 떠올리면 쉽다. 지나온 여정의 영수증을 전부 들고 다니면 가방이 무거워지고 정작 필요한 물건을 찾기 어렵다. 그렇다고 아무거나 버리면 나중에 꼭 필요한 서류를 잃는다. 좋은 여행자는 '다음 일정에 쓸 물건'만 가방에 넣고, 나머지는 숙소 금고에 맡겨 필요하면 다시 꺼낸다. CarryOn논문이 'Pack Light'라는 표현을 쓴 것도 같은 직관이다.
컨텍스트 엔지니어링의 판단 기준도 '앞으로 쓰일 가치'다. PAACE논문는 앞으로 이어질 몇 개 작업과의 관련성(next-k-task relevance)과 계획 구조를 보고 무엇을 압축할지 정한다. CAT논문는 작업 공간을 세 부분으로 나눈다. 변하지 않는 작업 목표, 압축된 장기 기억, 그리고 원래 모습 그대로 둔 최근 상호작용이다. 오래된 것은 줄이고 최근 것은 생생하게 두는 구조다.
그러니 컨텍스트 엔지니어링은 프롬프트를 '잘 쓰는' 기술이라기보다 한정된 공간을 '잘 나눠 쓰는' 기술에 가깝다. 공간은 정해져 있고, 작업 목표·기억·최근 기록·도구 설명이 그 공간을 두고 경쟁한다.
한정된 컨텍스트 나눠 쓰기
컨텍스트 윈도
작업 목표압축된 장기 기억최근 상호작용쌓이기만 한 옛 기록
어떻게 작동하나: 판단하고, 줄이고, 다시 보여 준다
여러 연구를 겹쳐 보면 공통 고리가 보인다. 첫째, 에이전트가 행동하고 관찰한 결과가 이력에 쌓인다. 둘째, 정해진 시점(일정 간격, 이정표, 예산 초과)에 무엇을 남길지 판단한다. 셋째, 남기지 않을 부분을 요약하거나, 한 줄 메모로 접거나, 짧은 카드로 바꾼다. 넷째, 이렇게 다듬은 컨텍스트를 모델에 보여 주고 다음 행동을 받는다. 그리고 이 고리를 반복한다.
세부 방법은 연구마다 다르다. SLIM논문은 검색과 페이지 읽기를 별개 도구로 나누고 Trajectory(지금까지의 행동 기록)를 주기적으로 요약한다. Context-Folding논문은 하위 작업을 처리할 때 곁가지를 하나 만들어 일하고, 끝나면 중간 단계를 접고 결과 요약만 남긴다. CADOC논문는 구조화된 객체를 짧은 검색용 카드로 바꾸되 원본은 필요할 때 정확히 다시 꺼낼 수 있게 둔다.
실제 도구에서는 이 고리가 더 넓은 하네스(Agent Harness, 모델을 감싸 도구·메모리·규칙을 붙이는 실행 틀) 안에 들어간다. 터미널 코딩 에이전트 OPENDEV논문는 오래된 관찰을 점진적으로 줄이는 적응형 압축, 필요할 때만 도구를 찾아 붙이는 지연 도구 탐색, 세션을 넘어 프로젝트 지식을 쌓는 자동 메모리, 그리고 지시가 대화 뒤로 밀려 희미해지는 현상(instruction fade-out)을 막는 이벤트 기반 시스템 알림을 함께 쓴다. 계획 담당과 실행 담당 에이전트를 나눈 것도 각자의 컨텍스트를 가볍게 유지하는 방법이다.
발전 흐름: 고정 규칙에서 학습된 정책으로
2025년 하반기 연구들은 '요약을 언제, 어떻게 할까'를 정교하게 만들었다. SLIM논문은 단순한 구조만으로도 o3 기반에서 BrowseComp 56%, HLE 33%를 기록해 오픈소스 프레임워크들보다 각각 8점, 6점 높았고, 도구 호출은 4~6배 적었다. Context-Folding논문은 접기 행동을 강화학습(FoldGRPO)으로 가르쳐, ReAct 기반 에이전트와 비슷하거나 더 나은 성능을 10배 작은 활성 컨텍스트로 냈고 요약 기반 관리보다 크게 앞섰다. PAACE논문는 계획을 고려한 압축 모델을 Teacher의 성공 시연에서 Distill해, 정확도를 높이면서 최대 컨텍스트 길이를 줄였다. CAT논문는 컨텍스트 관리를 에이전트가 직접 부르는 '도구'로 만들었고, 이렇게 학습한 SWE-Compressor는 SWE-Bench-Verified에서 57.6%를 풀었다.
2026년에 들어서는 '하나의 전략을 끝까지 고수하지 않는다'는 방향이 뚜렷해졌다. AgentSwing논문은 고정 전략이 어떤 상태에서는 잘 맞고 어떤 상태에서는 맞지 않는다고 보고, 전환 시점마다 여러 관리 방식을 병렬로 펼친 뒤 앞을 내다보고 가장 유망한 가지를 고른다. 그 결과 고정 방식과 비슷하거나 더 좋은 성능을 최대 3배 적은 대화 턴으로 냈다. ContextCurator논문는 관리와 실행을 분리해, 강화학습으로 훈련한 가벼운 큐레이터 모델이 잡음을 쳐내고 고정된 큰 모델이 작업을 한다. WebArena에서 Gemini-3.0-flash의 성공률을 36.4%에서 41.2%로 올리면서 토큰을 47.4K에서 43.3K로 줄였고, 7B 큐레이터가 GPT-4o 수준의 관리 성능을 냈다.
ContextEvo논문는 한 걸음 더 나아가 관리 정책 자체를 진화시킨다. 주요 결정 지점에서 모델이 실제로 본 컨텍스트를 복원하고, 컨텍스트 때문에 생긴 실패를 찾아 정책을 고친다. 오픈소스 Pi-agent 하네스에서 출발해 세 가지 장기 과제 벤치마크에서 Codex, OpenCode 같은 하네스와 비슷하거나 더 나은 결과를 냈다. 이 흐름을 요약하면 '사람이 정한 요약 규칙 → 학습된 압축·접기 → 환경에 맞춰 바뀌는 관리 정책'이다.
요즘 어디로 가고 있나: 되돌릴 수 있게, 모델 안으로, 행동에 맞게
첫째 방향은 '되돌릴 수 있는 관리'다. ReFold논문는 예측 모델이나 학습 없이 렌더링 층에서만 작동한다. 원래 이력은 그대로 두고 모델에 보여 줄 때만 압축한다. 이미 앞에서 보여 준 내용은 짧은 표시(stub)로 바꾸고, 에이전트가 끝났다고 밝힌 턴은 한 줄 메모로 접는다. 이렇게 지운 것은 이력에서 한 번에 복구할 수 있다. 또 매 단계가 아니라 몇 단계마다 한꺼번에 고쳐 써서 프롬프트 캐싱(앞부분이 같은 요청의 계산을 재사용하는 기법)이 덜 깨지게 했다. 다섯 개 벤치마크에서 성공률을 떨어뜨리지 않고 토큰을 최대 2.5배 줄였고, 세션당 KV 캐시 메모리를 절반으로 낮췄다.
둘째 방향은 편집을 하네스 바깥이 아니라 모델 안으로 넣는 것이다. NCE논문는 컨텍스트 편집 동작을 전용 특수 토큰의 '문법'으로 만들어, 모델이 답을 생성하는 도중 언어 자체로 자기 컨텍스트를 고치게 가르친다. 특정 하네스의 도구 호출 코드를 배우는 방식보다 다양한 작업에 일반화가 잘된다는 주장이다. Terminal-Bench 2.0과 SWE-bench 계열 네 벤치마크에서 기본 모델 대비 평균 성공률을 LongCat-Flash-Lite-Sparse는 5.6%p, Qwen3.6-35B-A3B는 4.5%p 올렸고, 토큰 사용은 각각 36%, 15% 줄였다.
셋째 방향은 '기법이 누구에게 맞는가'를 묻는 행동 연구다. 데이터 에이전트를 다룬 연구논문는 시맨틱 레이어(데이터를 설명하는 층), 여러 에이전트로 일을 나누는 오케스트레이션, 이력 압축(compaction)을 7개 LLM과 1,514개 장기 과제로 시험했다. 에이전트는 꼼꼼히 조사하는 유형, 데이터를 보지 않고 서둘러 답하는 유형, 일찍 포기하는 유형으로 나뉘었고, 각 기법은 맞는 유형에서만 정확도로 이어졌다. 꼼꼼한 유형에게는 오히려 해가 됐다. 시맨틱 레이어는 직접 들여다보기를 멈추게 했고, 오케스트레이션은 과신을 불러 5%p를 잃게 했으며, 압축은 같은 단계를 되풀이하게 했다. 기법을 합쳐도 효과는 각각의 합보다 작았다.
한계와 쟁점
가장 큰 위험은 잘못 지우는 것이다. ReFold논문는 기존의 예측형 방법들이 추가 모델 호출로 실행 부담을 늘리고, 프롬프트 캐시를 무효화하며, 지운 내용을 되살릴 보장이 없다고 비판한다. 압축이 '정답을 맞힐 수 있느냐'보다 '매번 안정적으로 맞히느냐'를 먼저 해친다는 관찰도 있다. PAIR논문는 같은 상태에서 압축한 경우와 안 한 경우를 맞대어 비교해, 심각한 성능 저하가 몇몇 개별 압축 시점에 몰린다는 것을 보였다.
언제 잊을지는 시점에 따라 달라진다. RECAP논문는 같은 실패 기록과 같은 요약을 두고도, 이른 시점의 압축은 실패하고 나중 시점의 압축은 비용 절감이 되는 사례를 보고했다. 즉 '이 정보는 중요하다·아니다'를 고정된 꼬리표로 붙이기 어렵다. 앞서 본 데이터 에이전트 연구논문처럼 에이전트 성향에 따라 효과가 뒤집히기도 하니, 남이 좋다고 한 기법을 그대로 가져오면 손해를 볼 수 있다.
수치를 읽을 때도 주의가 필요하다. 이 글의 성능·토큰 수치는 모두 특정 벤치마크와 특정 모델 조합에서 나온 것이고, 연구마다 벤치마크와 비교 대상이 다르다. 실제 서비스 환경에서 같은 이득이 나온다는 보장은 없다. 학습 기반 방법은 별도 모델 훈련이 필요하고, 렌더링 방식은 학습이 필요 없는 대신 판단이 단순하다는 맞교환도 있다.
지우는 방식 대 되돌릴 수 있는 방식
예측형 관리추가 모델·규칙·학습 정책
- 추가 모델 호출로 실행 부담
- 프롬프트 캐시가 깨질 수 있음
- 지운 내용 복구 보장 없음
되돌릴 수 있는 렌더링ReFold·CADOC 방식
- 원본 이력은 그대로 보존
- 몇 단계마다 묶어서 고쳐 써 캐시 재사용
- 잘못 지우면 한 번에 복구
공통 둘 다 모델에 보여 줄 컨텍스트를 줄이는 것이 목표
더 공부하려면
처음이라면 SLIM논문부터 읽기를 권한다. 장기 검색 에이전트가 왜 컨텍스트 때문에 실패하는지 오류 분류로 보여 주고, 해법도 단순해 문제의식을 잡기 좋다. 이어서 실제 도구의 설계 감각을 원하면 OPENDEV논문를 읽는다. 압축·메모리·시스템 알림·도구 지연 로딩이 한 하네스 안에서 어떻게 맞물리는지 볼 수 있다.
학습 기반 접근이 궁금하면 Context-Folding논문과 CAT논문를 함께 읽는다. 하나는 접기를 강화학습으로, 다른 하나는 컨텍스트 관리를 도구 호출로 가르친다. 관리 정책을 상황에 맞게 바꾸는 시각은 AgentSwing논문과 ContextEvo논문가 잘 보여 준다.
최근 흐름은 ReFold논문로 되돌릴 수 있는 설계와 캐시 문제를, NCE논문로 모델 고유 능력으로서의 편집을, 데이터 에이전트 행동 연구논문로 '기법을 고르는 기준'을 살펴보면 된다. 관련 용어로는 컨텍스트 윈도, 프롬프트 캐싱, 하네스, 에이전트 메모리를 먼저 익혀 두면 읽기가 수월하다.
관련 용어
컨텍스트 윈도 프롬프트 엔지니어링 프롬프트 캐싱 하네스 에이전트 메모리 KV 캐시 서브에이전트 AI 에이전트
참고 문헌
핵심 논문
- Lost in the Maze: Overcoming Context Limitations in Long-Horizon Agentic Search (2025)
- Scaling Long-Horizon LLM Agent via Context-Folding (2025)
- PAACE: A Plan-Aware Automated Agent Context Engineering Framework (2025)
- Context as a Tool: Context Management for Long-Horizon SWE-Agents (2025)
- Building Effective AI Coding Agents for the Terminal: Scaffolding, Harness, Context Engineering, and Lessons Learned (2026)
- AgentSwing: Adaptive Parallel Context Management Routing for Long-Horizon Web Agents (2026)
- Escaping the Context Bottleneck: Active Context Curation for LLM Agents via Reinforcement Learning (2026)
- Beyond Skill Evolution: Self-Evolving Context Management Policies for Long-Horizon Agent Harnesses (2026)
최근 연구
AI가 참고 문헌을 바탕으로 작성하고 검수를 거친 해설입니다. 정확한 내용은 원문을 확인해 주세요.