专题深读 · 2026-10-22 · 进阶
长上下文(Long Context):位置编码扩展与“Lost in the Middle”
扩大上下文窗口可以分为两个问题:一是让模型能够处理比训练时更长的位置,二是让模型真正找到并利用输入的信息。本笔记依次梳理位置编码、内存开销和评估方法,并总结研究如何衡量模型在长输入中遗漏位于中间或分散在多处的信息这一现象。
- 扩大窗口与用好窗口内的信息是两种不同的能力。能接收长输入,并不意味着能读完并用上其中的全部内容。
- RoPE 等位置编码在超出训练时见过的位置范围后会变得不稳定。把位置编号重新调整到训练范围之内,是一种应对方法。
- 所需证据在输入中越分散、需要的多步推理越多,长度增加时性能下降就越明显。“Lost in the Middle”是这一问题的典型表现。
- 现有基准偏重简单查找(recall),因此不断出现把模型原有知识与长上下文能力分开衡量的新评估方法。
- 在实际服务中,KV 缓存内存、预填充阶段的峰值内存以及智能体记录管理会成为瓶颈。因此,基于地址的记录、延迟 KV 删除等系统层面的方案也在同步发展。
为什么需要长上下文
LLM(大语言模型)一次能读取的最大输入长度称为上下文窗口。最初几千个 token 就够用了。但随着把整份长合同或一批论文直接输入、或运行长达数小时持续调用工具的智能体等需求增多,窗口开始不够用。一项关于长时程任务智能体的研究(paper)指出,推理记录、动作和工具观测结果不断累积,最终会超出固定的窗口。
关于“看得更长为什么更好”,解释也比想象中更多样。一项时间序列预测研究(paper)对通常仅以“能捕捉远距离依赖关系”来解释长观测窗口优势的说法提出了质疑。该研究认为,长窗口能够降低对“当前数据由哪种生成过程产生”的不确定性。研究还证明,即使对于记忆长度为 P 的过程,要达到最小误差,窗口大小也必须大于 P。这意味着长上下文不仅用于直接参照遥远的过去,也用于识别当前所处的情境本身。
问题在于窗口无法简单地加长。遇到训练时没见过的位置,模型会变得不稳定;内存随长度成比例增长;在变长的输入中遗漏重要信息的情况也更常见。本笔记依次讨论这三点。
核心思路:桌子大小与阅读能力是两回事
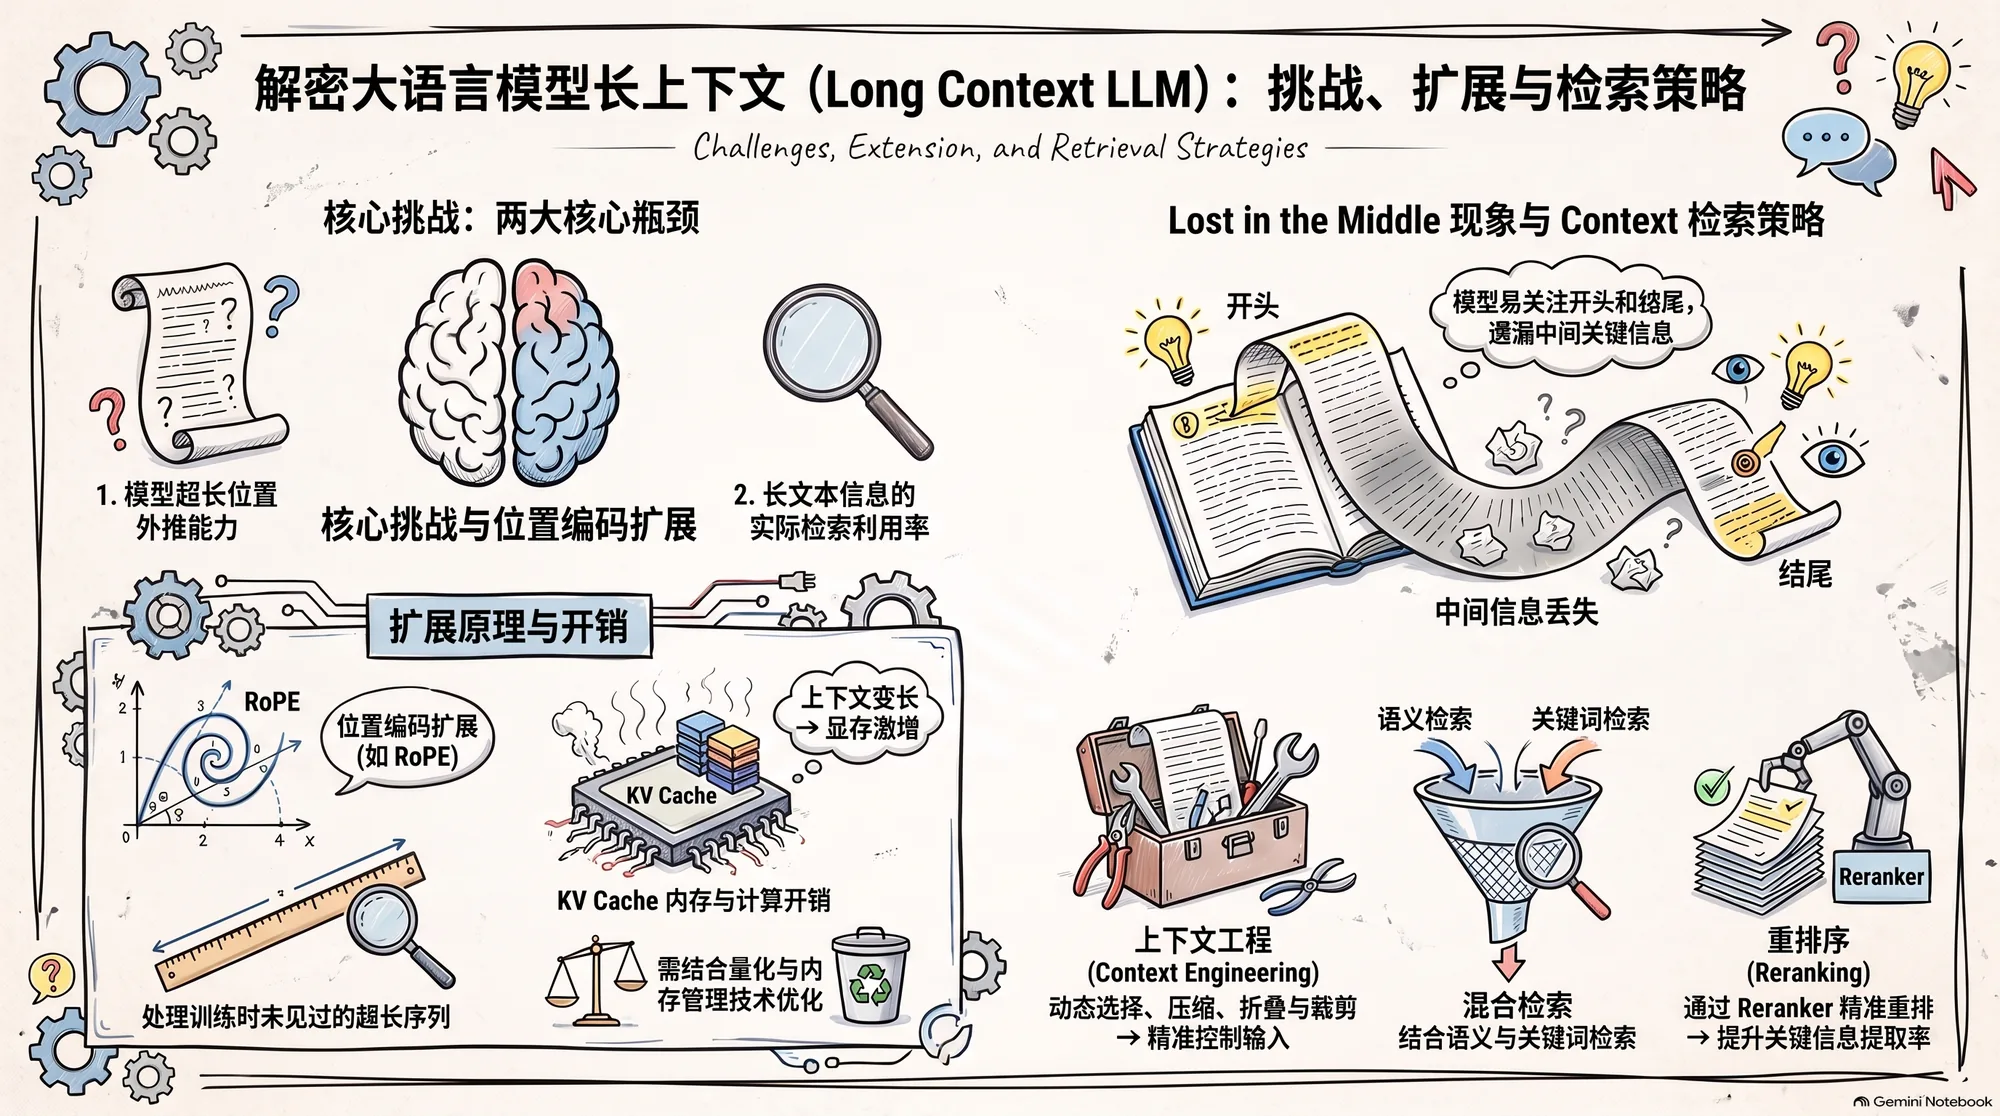
长上下文可以用书桌来比喻。上下文窗口是桌子的大小,模型则是查看桌上摊开资料的人。要扩大桌子,首先需要让标记每份资料“放在第几个位置”的方法在更大的桌子上依然有效,这就是位置编码扩展的问题。其次,还需要有能容纳更大桌子的空间和成本,也就是内存。
桌子变大了,并不代表人会仔细阅读桌上的每一张纸。最前面和最后面的资料看得清楚,埋在中间的资料却容易被忽略。业界通常把这种倾向称为“Lost in the Middle”。本笔记的输入资料中没有首次测量这一现象的研究,因此不列举具体数值,而是通过从不同角度衡量同一问题的近期研究来加以考察。
总结来说,长上下文研究分为三个方向:处理位置的方法、应对内存与速度的方法,以及让模型真正用上输入信息并正确衡量这种能力的方法。只解决其中之一,并不能成为“善用长上下文的模型”。
工作原理:位置编码与长度扩展
Transformer 的注意力(Attention)会一次性比较所有 token,因此如果不另行告知,它并不知道 token 的顺序。目前广泛使用的 RoPE(旋转位置编码)把每个 token 的查询向量和键向量旋转一个与位置成比例的角度,以此表示顺序。比较两个 token 时,旋转角度之差,也就是相对距离,会反映在结果中。按一般原理来看,当出现训练时没见过的大位置编号时,模型会遇到陌生的旋转角度,性能可能变得不稳定。
因此,扩展长度的一个代表性方向,是把位置编号重新调整到训练时见过的范围之内。一项长上下文推测解码研究(paper)就是很好的例子。推测解码是一种加速技术:由廉价的草稿模型(drafter)先写出几个 token,再由大模型一次性验证。该研究指出,当上下文变得非常长时,草稿模型也必须对前面的全部内容做注意力计算,成本随之上升,加速效果逐渐减弱,甚至出现反转。常见的解决方案是重新训练一个面向长上下文的草稿模型。该研究则保持面向短上下文的草稿模型冻结不变,只在推理阶段加入两个机制:一是限制草稿模型可见的注意力缓存范围,使成本保持固定;二是把旋转位置编号重新调整(re-base)到训练范围之内。
这种方法之所以有效,是因为草稿模型读取的是大模型的隐藏表示(Hidden Representation),也就是大模型看过前面全部内容后计算出的内部状态。远处的上下文已包含在该状态中,草稿模型遗漏的部分也会在验证阶段被纠正。研究人员证明了在何种条件下,对位置编号做统一平移后,草稿模型的计算结果完全不变。他们报告称,在不改动权重的情况下,仅通过一项 vLLM 配置即可支持从 4k 到 200 万 token 的长度,而在短长度下损失的加速最多为 0.16 倍。
长度增加后,内存也会成为问题。生成过程中用于保存先前 token 的键和值的 KV 缓存,会随输入长度成比例增长。TideKV(paper)没有聚焦已被大量研究的生成阶段内存,而是指出首次读取提示词的预填充阶段的峰值内存才是问题所在。
“Lost in the Middle”:长并不等于全读
即使扩大了窗口、也能承担内存开销,问题也没有结束。还剩下一个问题:模型是否真的能找到并利用长输入中某处的信息。“Lost in the Middle”是这种失败的一种外在表现。近期研究不仅关注“信息在哪里”,还从“信息有多分散”的角度拓宽了对这一问题的考察。
LURCH 基准(paper)把长上下文任务的难度分为三种属性:需要查找的证据量(evidence scope)、证据在输入中分散的广度(evidence dispersion),以及得出答案需要连续推理多少步(reasoning depth)。基于 6,550 道题的评估显示,即使长度相同,这三种属性也都与性能呈强负相关。随着长度增加,证据分散的题目性能急剧下降,而证据集中在一处的题目则相对稳定。另一个值得注意的结果是,三种属性都处于一定高度的题目,比只有一种属性极端偏高的题目更难。
这一结果让人能在更宽的视角下理解“Lost in the Middle”。问题的核心不只是中间位置,而在于模型不擅长把分散在长输入各处的片段汇总并串联起来。能顺利通过在一处寻找一根针的测试(Needle-in-a-Haystack),并不能保证具备串联分散证据的能力。
发展脉络:从评估到记忆机制
起点研究大致分为两个方向。第一个方向是追问“是否真的在衡量长上下文能力”的评估研究。100-LongBench(paper)指出,LongBench 等现有的真实任务基准存在两个弱点:缺少将长上下文性能与模型基础能力分开的指标;输入长度固定,无法显示模型在什么长度上崩溃。该研究提出了可调节长度的基准,以及把模型原有知识与真正的长上下文能力区分开来的指标。Ref-Long(paper)不再采用简单查找,而是设计了要求说出引用特定键的文档编号的“引用(referencing)”任务。对 13 个模型的测试显示,即使是 GPT-4o 这样的模型,在该任务上也表现出明显弱点。
也有研究考察了在实际工作中扩大窗口的效果。一项文献综述生成研究(paper)中,两名研究人员按 15 项标准评估了 20 篇由 AI 撰写的综述。窗口变长后,综述涵盖的信息更广,在长输入下也能保持一致性,但内容重复、遗漏关键研究、偏重罗列而非综合等问题反而更加严重。该研究最终得出结论:仍需要专家审核。
第二个方向是不受窗口大小限制的记忆方法。ARC(paper)把智能体的工具观测结果保存在只追加、按 ID 寻址的记录中。需要压缩时,把较早的观测替换为简短的引用(ID),智能体在需要时可凭该 ID 重新调取原文,无需重新执行工具,也不必只依赖相似度检索。使用 16k 窗口的 Qwen3-8B 和 32k 窗口的 Qwen3-32B 进行的实验中,Needle-in-a-Haystack 平均准确率为 99.40%,高于对比方法中最好的 88.12%。在 LongBench-v2 Hard 上则为 29.97% 对 28.25%。一项残差向量重构研究(paper)提出了一种无需额外训练的方法:把原文事实以残差向量的形式存入前馈层的激活中,再根据问题重构相应的事实。研究报告称,即使上下文变长,GPU 内存也几乎保持不变,并能在长达 200 万 token 的故事中回答单一事实问题。
ARC 与最佳对比方法
ARC最佳对比方法
最新进展方向
近期研究中有三个明显的趋势。第一,不再只用长度这一个指标衡量难度。正如前面介绍的 LURCH(paper)所示,评估正在转向分别衡量证据的数量、分散程度和推理深度,因为只有这样才能看出模型为什么出错。
第二,在证据层面讨论“RAG 还是长上下文”。有据生成诊断研究(paper)让模型在给出答案的同时给出逐行引用,并同时对答案是否正确和证据呈现进行评分。对 10 个商用最新模型和 3 个开放权重模型进行测试后发现,RAG(检索增强生成)存在两项长上下文模型能够避开的局限。相似度检索很擅长找到“一个”相关片段,但在需要多个事实的问题中,找到“所有需要的片段”的能力要弱得多。此外,分块(文档切分)会抹掉识别身份所需的文档元信息。不过,长上下文一方也并不完美。在有两根“针”的设置中,有时会漏掉引用;当上下文与模型已有知识相矛盾时,“仅答案正确”与“答案和证据都正确”之间的差距会拉大。
第三,通过系统设计解决内存瓶颈。TideKV(paper)采用“延迟删除”方式:逐层处理完所有提示片段后,在该层结束时删除 KV。这样既能在看过完整提示的前提下选择要保留的 KV,又能降低峰值内存。在 A100 上、64K 长度下,构建缓存期间的峰值内存降低了 83.89%。在 RTX 4090 上,它在 TTFT(首个 token 生成时间)仅增加 1.06% 的情况下实现了 128K 预填充。
RAG 与长上下文模型
RAG切分后检索阅读
- 擅长找到一个相关片段
- 容易漏掉所需的全部片段
- 分块会抹掉文档元信息
长上下文模型整体放入后阅读
- 避开 RAG 的两项局限
- 两根针时漏掉引用
- 与已有知识矛盾时出现证据差距
공통 两者都不能只看答案,还要同时核对证据
局限与争议
最大的争议在于,“窗口大小”这个数字很容易夸大实际能力。正如 100-LongBench(paper)所指出的,即使分数很高,也难以区分这究竟来自长上下文能力,还是得益于模型原有的知识。Ref-Long(paper)和 LURCH(paper)表明,在超出简单查找的任务上,模型仍然较弱。即使模型宣传支持很长的窗口,如果你的工作属于“串联分散证据”的类型,也应亲自验证。
增加长度也可能使质量的其他方面变差。在文献综述研究(paper)中,长窗口加剧了重复和关键内容遗漏。位置重映射等技术也有其适用范围。长上下文草稿模型研究(paper)之所以效果良好,是因为其结构中草稿模型读取大模型的内部状态,并由验证步骤纠正错误。不应将这一结果泛化理解为:只要做位置重映射,任何模型都能扩展长度。
记忆装置类方案也有前提条件。ARC(paper)自己说明,它是“在所实验的设置内”优于所评估的基线方法。残差向量方法(paper)也只报告了在单一事实问题上的成果。至于在需要串联多个事实的问题上效果如何,仅凭这些资料无法得知。
延伸学习
如果想先建立评估视角,建议先读 100-LongBench(paper),理解如何单独衡量“长上下文能力”。接着读 LURCH(paper),可以用证据分散程度和推理深度的框架重新审视“Lost in the Middle”类失败。Ref-Long(paper)是展示查找与引用之间差异的补充资料。
如果想了解位置编码扩展在实际中如何使用,长上下文草稿模型研究(paper)是不错的选择。它具体讨论了将 RoPE 位置编号映射回训练范围的思路,以及这样做不改变计算结果的条件。服务成本方面,可以接着读 TideKV(paper)。
如果你在设计智能体或 RAG,建议将 ARC(paper)和有据生成诊断研究(paper)一起阅读。对于“哪些内容放在窗口内、哪些放在外部再调用”这一上下文工程问题,两者给出了不同的答案。如果想从理论上理解长窗口为什么有帮助,时间序列研究(paper)简短而清晰。
相关术语
参考资料
奠基论文
- Long-Context Drafting Does Not Require Long-Context Drafters (2026)
- 100-LongBench: Are de facto Long-Context Benchmarks Literally Evaluating Long-Context Ability? (2025)
- Ref-Long: Benchmarking the Long-context Referencing Capability of Long-context Language Models (2025)
- Addressable Recall Compaction for Long Context-Window Control in AI Agents (2026)
- Residual Vector-based Reconstruction as Long-Context Recall Regardless of Context Window Size (2026)
- Why Do Time Series Models Need Long Context Windows? (2026)
- LLMs for Academic Workflows: An Evaluation of Literature Reviews Generated with Short and Long Context Windows of LLMs (2026)
最新研究
- Beyond Context Length: Characterising the Difficulty of Long-Context Reasoning (2026)
- TideKV: Delayed KV Eviction via Layer-Wise Chunked Prefill for Memory-Efficient Long-Context LLM Inference (2026)
- The Bottleneck Is Retrieval, Not Reading: Diagnosing Evidence-Based Generation with RAG for Long Context Question Answering (2026)
由 AI 根据所列参考资料撰写并经过审核。详情请查看原始资料。