주제 탐구 · 2026-10-22 · 심화
긴 문맥(Long Context): 위치 인코딩 확장과 'Lost in the Middle'
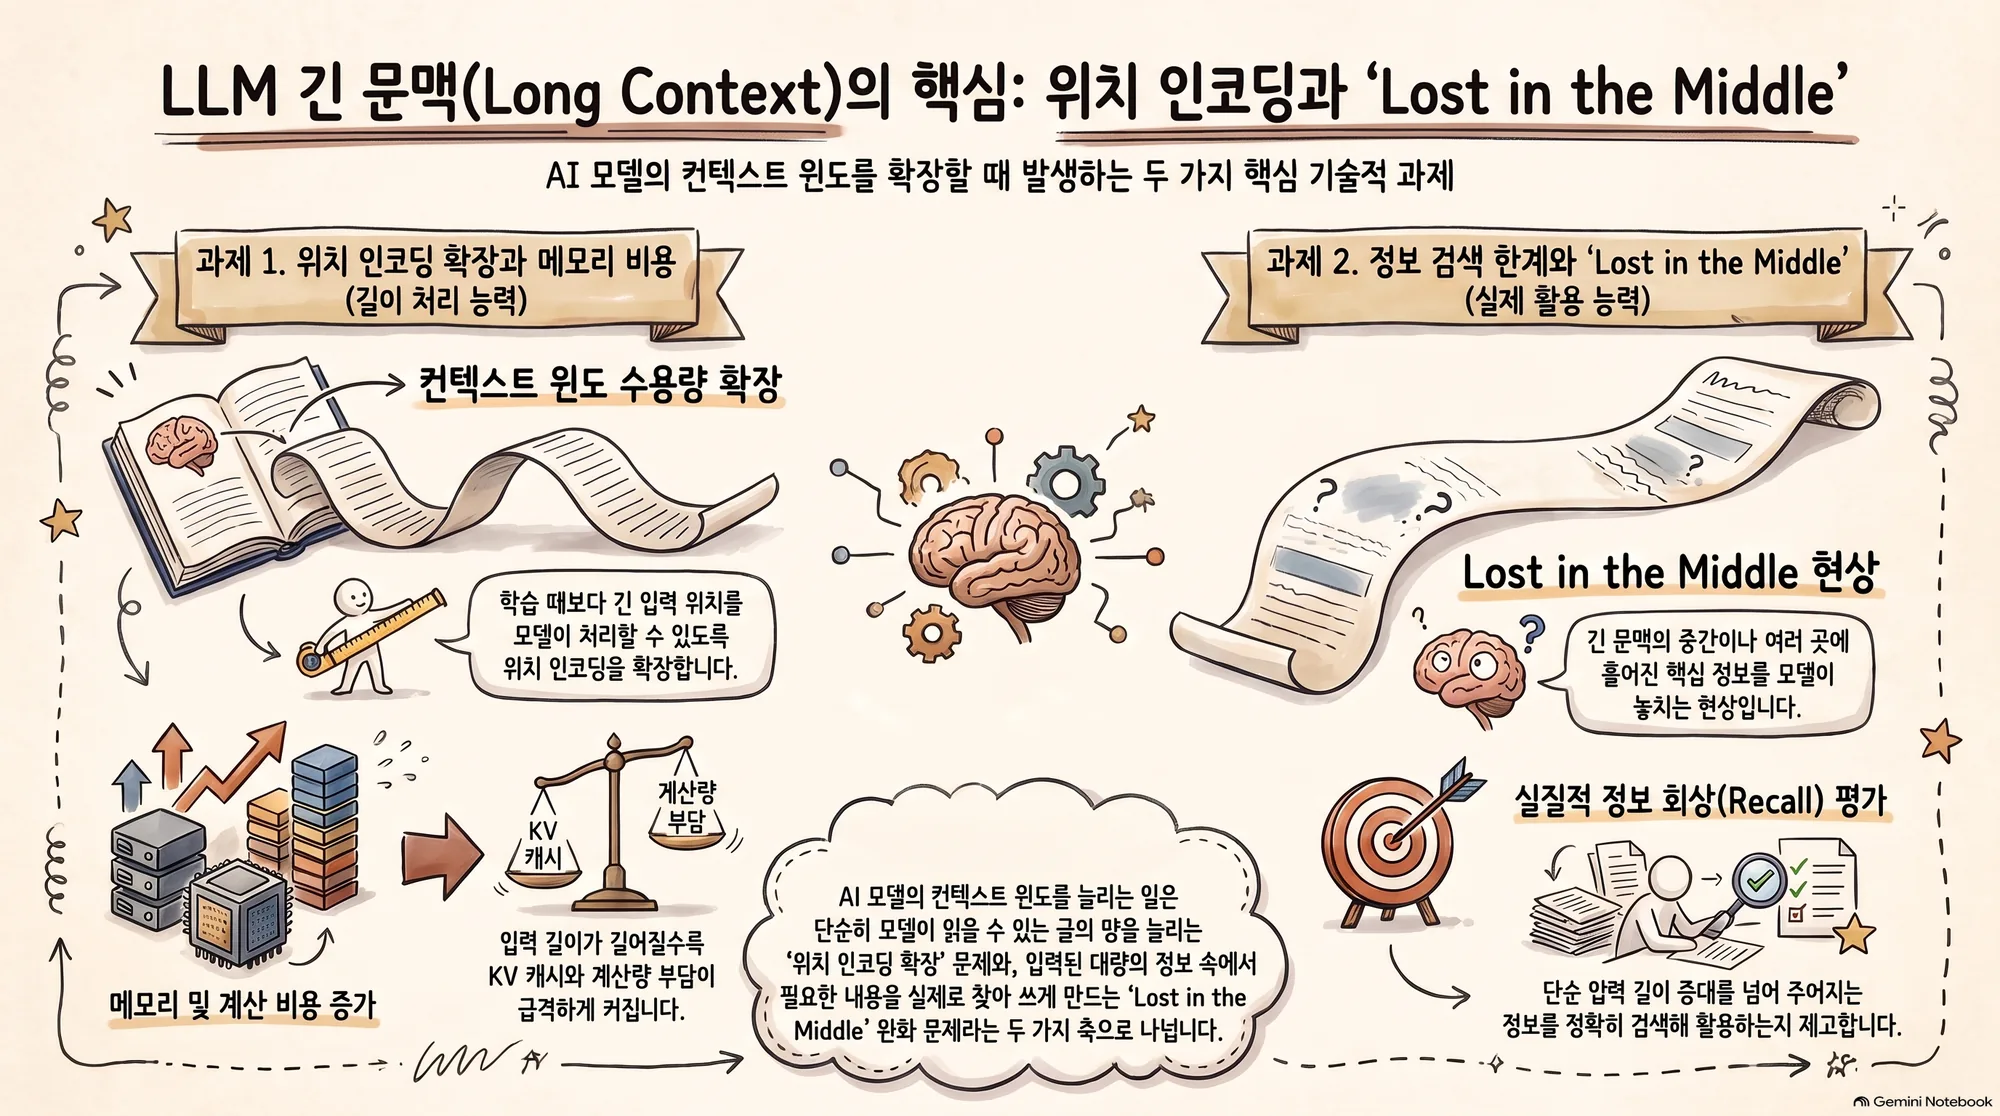
컨텍스트 윈도를 늘리는 일은 두 가지 문제로 나뉜다. 학습 때보다 긴 위치를 모델이 다룰 수 있게 하는 문제와, 넣은 정보를 실제로 찾아 쓰게 하는 문제다. 이 노트는 위치 인코딩·메모리 비용·평가 방법을 차례로 짚고, 긴 입력에서 가운데나 여러 곳에 흩어진 정보를 놓치는 현상을 연구들이 어떻게 재고 있는지 정리한다.
목차
- 윈도를 키우는 것과 그 안의 정보를 제대로 쓰는 것은 서로 다른 능력이다. 긴 입력을 받는다고 해서 그 내용을 다 읽고 쓴다는 뜻은 아니다.
- RoPE 같은 위치 인코딩은 학습 때 본 위치 범위를 벗어나면 흔들린다. 위치 번호를 학습 범위 안으로 다시 맞춰 주는 방법이 한 가지 대응책이다.
- 필요한 근거가 입력 곳곳에 흩어질수록, 그리고 여러 단계로 추론해야 할수록 길이가 늘 때 성능이 크게 떨어진다. 'Lost in the Middle'은 이 문제가 드러나는 대표적인 모습이다.
- 기존 벤치마크는 단순 찾기(recall)에 치우쳐 있어서, 모델의 원래 지식과 긴 문맥 능력을 따로 떼어 재는 평가가 새로 나오고 있다.
- 실제 서비스에서는 KV 캐시 메모리, 프리필 순간 메모리, 에이전트 기록 관리가 병목이 된다. 그래서 주소 기반 기록, 늦춘 KV 삭제 같은 시스템 쪽 해법이 함께 발전하고 있다.
왜 긴 문맥이 필요했나
LLM(대규모 언어 모델)이 한 번에 읽을 수 있는 입력의 최대 길이를 컨텍스트 윈도라고 한다. 처음에는 몇천 토큰이면 충분했다. 그런데 긴 계약서·논문 묶음을 통째로 넣거나, 여러 시간 동안 도구를 부르며 일하는 에이전트를 돌리는 일이 늘면서 윈도가 모자라기 시작했다. 장기 작업을 하는 에이전트에 관한 연구논문는 추론 기록, 행동, 도구 관찰 결과가 쌓이다 보면 결국 고정된 윈도를 넘어선다고 지적한다.
'더 길게 보면 왜 좋은가'에 대해서도 생각보다 다양한 설명이 있다. 시계열 예측 연구논문는 긴 관측 창의 이점을 흔히 '멀리 떨어진 의존 관계를 잡아서'라고만 설명하는 데 의문을 던진다. 이 연구에 따르면 긴 창은 지금 들어온 데이터를 어떤 생성 과정이 만들었는지에 대한 불확실성을 줄여 준다. 또 메모리 길이가 P인 과정에서도 최소 오차에 이르려면 창 크기가 P보다 반드시 커야 함을 증명했다. 긴 문맥은 먼 과거를 직접 참조하는 데만 쓰이는 게 아니라, 상황 자체를 알아보는 데도 쓰인다는 뜻이다.
문제는 윈도를 그냥 늘릴 수 없다는 점이다. 학습 때 본 적 없는 위치가 들어오면 모델이 흔들리고, 길이에 비례해 메모리가 늘며, 길어진 입력 안에서 중요한 정보를 놓치는 일이 잦아진다. 이 노트는 이 세 가지를 차례로 다룬다.
핵심 아이디어: 책상 크기와 읽는 능력은 다르다
긴 문맥은 책상에 비유할 수 있다. 컨텍스트 윈도는 책상 크기이고, 모델은 그 위에 펼친 자료를 보는 사람이다. 책상을 넓히려면 먼저 자료마다 '몇 번째 자리에 놓였는지' 표시하는 방법이 넓은 책상에서도 통해야 한다. 이것이 위치 인코딩 확장의 문제다. 그다음에는 넓어진 책상을 감당할 공간과 비용, 곧 메모리가 있어야 한다.
책상이 넓어졌다고 사람이 그 위의 모든 종이를 꼼꼼히 읽는 것은 아니다. 맨 앞과 맨 뒤 자료는 잘 보지만 가운데에 묻힌 자료는 흘려보내기 쉽다. 업계에서는 이 경향을 흔히 'Lost in the Middle'이라고 부른다. 이 노트의 입력 자료에는 이 현상을 처음 측정한 연구가 없다. 그래서 구체적 수치는 들지 않고, 같은 문제를 다른 각도에서 잰 최근 연구로 살펴본다.
정리하면 긴 문맥 연구는 세 갈래다. 위치를 다루는 방법, 메모리와 속도를 감당하는 방법, 넣은 정보를 실제로 쓰게 하고 그 능력을 제대로 재는 방법이다. 셋 중 하나만 풀어서는 '긴 문맥을 잘 쓰는 모델'이 되지 않는다.
어떻게 작동하나: 위치 인코딩과 길이 확장
트랜스포머의 어텐션(Attention)은 모든 토큰을 한꺼번에 비교한다. 그래서 따로 알려 주지 않으면 토큰의 순서를 모른다. 요즘 많이 쓰는 RoPE(회전 위치 임베딩)는 각 토큰의 질의·키 벡터를 위치에 비례하는 각도만큼 돌려서 순서를 알려 준다. 두 토큰을 비교할 때는 회전 각도의 차이, 곧 상대 거리가 결과에 반영된다. 일반적인 원리로 보면, 학습 때 본 적 없는 큰 위치 번호가 들어오면 모델은 낯선 회전 각도를 만나고 성능이 흔들릴 수 있다.
그래서 길이를 늘리는 대표적인 방향 중 하나는 위치 번호를 학습 때 본 범위 안으로 다시 맞춰 주는 것이다. 긴 문맥 추측 디코딩 연구논문가 좋은 예다. 추측 디코딩은 값싼 초안 모델(drafter)이 몇 토큰을 먼저 써 두면 큰 모델이 한꺼번에 검증하는 가속 기법이다. 이 연구에 따르면 문맥이 아주 길어지면 초안 모델도 앞부분 전체에 어텐션을 걸어야 해서 비용이 커지고, 가속 효과가 줄다가 오히려 역전된다. 흔한 해법은 긴 문맥용 초안 모델을 새로 학습하는 것이다. 이 연구는 대신 짧은 문맥용 초안 모델을 그대로 얼려 두고 추론 시점의 장치 두 가지만 더했다. 하나는 초안 모델이 보는 어텐션 캐시 범위를 제한해 비용을 고정하는 것이고, 다른 하나는 회전 위치 번호를 학습 범위 안으로 다시 맞추는(re-base) 것이다.
이 방법이 통하는 이유는 초안 모델이 큰 모델의 Hidden Representation, 곧 큰 모델이 앞부분 전체를 보고 계산한 내부 상태를 읽기 때문이다. 먼 문맥은 이미 그 상태에 담겨 들어오고, 초안 모델이 놓친 부분은 검증 단계에서 바로잡힌다. 연구진은 위치 번호를 일정하게 옮겨도 초안 모델의 계산이 정확히 그대로인 조건을 증명했다. 가중치를 건드리지 않은 vLLM 설정 하나로 4k에서 200만 토큰까지 쓸 수 있었고, 짧은 길이에서 잃는 가속은 최대 0.16배였다고 보고한다.
길이가 늘면 메모리도 문제가 된다. 생성 중에 앞 토큰의 키·값을 저장해 두는 KV 캐시는 입력 길이에 비례해 커진다. TideKV논문는 이미 많이 연구된 생성 단계 메모리보다, 프롬프트를 처음 읽는 프리필 단계의 순간 최대 메모리를 문제로 짚는다.
'Lost in the Middle': 길다고 다 읽는 것은 아니다
윈도를 늘리고 메모리를 감당하게 됐다고 문제가 끝나지는 않는다. 긴 입력 어딘가에 있는 정보를 실제로 찾아 쓰는지가 남는다. 'Lost in the Middle'은 그 실패가 겉으로 드러나는 한 모습이다. 최근 연구들은 '어디에 있느냐'만이 아니라 '얼마나 흩어져 있느냐'로 문제를 넓혀 보고 있다.
LURCH 벤치마크논문는 긴 문맥 과제의 어려움을 세 가지 성질로 나눈다. 찾아야 할 근거의 양(evidence scope), 근거가 입력 안에 얼마나 넓게 흩어져 있는가(evidence dispersion), 답에 이르기까지 몇 단계를 이어서 추론해야 하는가(reasoning depth)다. 6,550개 문항으로 평가한 결과, 길이가 같을 때도 세 성질 모두 성능과 강한 음의 상관을 보였다. 길이가 늘수록 근거가 흩어진 문항에서는 성능이 급격히 떨어졌지만, 근거가 한곳에 모인 문항에서는 비교적 안정적이었다. 세 성질이 모두 어느 정도 높은 문항이 하나만 극단적으로 높은 문항보다 더 어려웠다는 점도 눈에 띈다.
이 결과는 'Lost in the Middle'을 넓은 맥락에서 이해하게 해 준다. 문제의 핵심은 단지 가운데 위치가 아니다. 모델이 긴 입력 곳곳에 흩어진 조각을 모아 엮는 데 약하다는 점이다. 한곳에 있는 바늘 하나를 찾는 시험(Needle-in-a-Haystack)을 잘 통과한다고 해서 흩어진 근거를 엮는 능력까지 보장되지는 않는다.
발전 흐름: 평가에서 기억 장치까지
출발점 연구들은 크게 두 갈래다. 첫째는 '정말 긴 문맥 능력을 재고 있는가'를 묻는 평가 연구다. 100-LongBench논문는 LongBench 같은 기존 실제 과제 벤치마크에 두 가지 약점이 있다고 지적했다. 긴 문맥 성능과 모델의 기본 능력을 분리하는 지표가 없고, 입력 길이가 고정돼 있어 모델이 어느 길이에서 무너지는지 보여 주지 못한다는 것이다. 이 연구는 길이를 조절할 수 있는 벤치마크와, 모델의 원래 지식과 진짜 긴 문맥 능력을 떼어 내는 지표를 제안했다. Ref-Long논문은 단순한 찾기 대신 특정 키를 참조하는 문서의 번호를 대게 하는 '참조(referencing)' 과제를 만들었다. 13개 모델을 시험한 결과 GPT-4o 같은 모델도 이 과제에서 뚜렷한 약점을 보였다.
실제 업무에서 윈도를 늘린 효과를 본 연구도 있다. 문헌 리뷰 생성 연구논문에서는 연구자 두 명이 AI가 쓴 리뷰 20편을 15개 기준으로 평가했다. 윈도가 길어지면 더 넓은 정보를 담고 긴 입력에서도 일관성을 유지했지만, 내용 반복, 핵심 연구 누락, 종합보다 나열에 치우치는 문제는 오히려 심해졌다. 이 연구는 결국 전문가의 검토가 필요하다고 결론지었다.
둘째 갈래는 윈도 크기에 묶이지 않고 기억하게 하는 방법이다. ARC논문는 에이전트의 도구 관찰 결과를 덧붙이기만 하는 ID 주소 기록에 보관한다. 압축이 필요해지면 오래된 관찰을 짧은 인용(ID)으로 바꿔 두고, 에이전트가 필요할 때 그 ID로 원문을 다시 불러오게 했다. 도구를 다시 실행하거나 유사도 검색에만 기대지 않아도 된다. 16k 윈도의 Qwen3-8B와 32k 윈도의 Qwen3-32B로 실험한 결과, Needle-in-a-Haystack 평균 정답률은 99.40%로 비교 방식 중 가장 나은 88.12%보다 높았다. LongBench-v2 Hard에서는 29.97% 대 28.25%였다. 잔차 벡터 재구성 연구논문는 추가 학습 없이, 피드포워드 층의 활성화에 원문 사실을 잔차 벡터로 담아 두었다가 질문에 맞는 사실을 재구성하는 방법을 제안했다. 문맥이 길어져도 GPU 메모리를 거의 일정하게 유지하면서, 200만 토큰 길이의 이야기에서 단일 사실 질문에 답할 수 있었다고 보고한다.
ARC와 가장 나은 비교 방식
ARC가장 나은 비교 방식
요즘 어디로 가고 있나
최근 연구에서 눈에 띄는 흐름은 세 가지다. 첫째, 어려움을 길이 하나로 재지 않는다. 앞에서 본 LURCH논문처럼 근거의 양, 흩어짐, 추론 깊이를 나눠 재야 모델이 왜 틀리는지 보인다는 쪽으로 평가가 옮겨 가고 있다.
둘째, 'RAG냐 긴 문맥이냐'를 증거 수준에서 따져 본다. 근거 기반 생성 진단 연구논문는 모델이 답과 함께 줄 단위 인용을 내게 하고, 정답 여부와 근거 제시를 함께 채점했다. 상용 최신 모델 10개와 오픈웨이트 모델 3개를 시험한 결과, RAG(검색 증강 생성)에는 긴 문맥 모델이 피하는 두 가지 한계가 있었다. 유사도 검색은 관련 조각 '하나'는 잘 찾지만 여러 사실이 필요한 질문에서 '필요한 조각 전부'를 찾는 데는 훨씬 약했다. 또 청킹(문서 분할)이 정체를 가리는 데 필요한 문서 메타 정보를 지워 버렸다. 다만 긴 문맥 쪽도 완벽하지 않았다. 바늘이 두 개인 설정에서는 인용이 빠지기도 했고, 문맥이 모델의 기존 지식과 어긋날 때 '답만 맞는 경우'와 '답과 근거가 모두 맞는 경우'의 격차가 벌어졌다.
셋째, 메모리 병목을 시스템 설계로 푼다. TideKV논문는 층 단위로 프롬프트 조각을 모두 처리한 뒤 그 층이 끝날 때 KV를 삭제하는 '늦춘 삭제' 방식을 쓴다. 전체 프롬프트를 본 상태에서 남길 KV를 고르면서도 순간 메모리를 줄인다. A100의 64K 길이에서 캐시를 만드는 동안의 순간 메모리를 83.89% 줄였다. RTX 4090에서는 TTFT(첫 토큰까지 걸리는 시간)를 1.06%만 늘리면서 128K 프리필을 가능하게 했다.
RAG 대 긴 문맥 모델
RAG잘라서 찾아 읽기
- 관련 조각 하나는 잘 찾음
- 필요한 조각 전부는 놓치기 쉬움
- 청킹이 문서 메타 정보를 지움
긴 문맥 모델통째로 넣고 읽기
- RAG의 두 한계를 피함
- 바늘 두 개일 때 인용 누락
- 기존 지식과 어긋나면 근거 격차
공통 둘 다 답만이 아니라 근거까지 함께 확인해야 한다
한계와 쟁점
가장 큰 쟁점은 '윈도 크기'라는 숫자가 실제 능력을 과대 포장하기 쉽다는 점이다. 100-LongBench논문가 지적했듯 점수가 높아도 그것이 긴 문맥 능력인지 원래 지식 덕분인지 구분하기 어렵다. Ref-Long논문과 LURCH논문는 단순 찾기를 넘는 과제에서 모델이 아직 약하다는 점을 보여 준다. 긴 윈도를 광고하는 모델이라도 내 업무가 '흩어진 근거를 엮는' 종류라면 직접 확인해 봐야 한다.
길이를 늘리면 품질의 다른 면이 나빠질 수도 있다. 문헌 리뷰 연구논문에서 긴 윈도는 반복과 핵심 누락을 키웠다. 위치 재배치 같은 기법도 적용 범위가 정해져 있다. 긴 문맥 초안 모델 연구논문가 잘 작동한 것은 초안 모델이 큰 모델의 내부 상태를 읽고 검증 단계가 오류를 바로잡는 구조였기 때문이다. 이 결과를 위치 재배치만 하면 어떤 모델이든 길이를 늘릴 수 있다는 뜻으로 넓혀 읽으면 안 된다.
기억 장치형 해법에도 조건이 붙는다. ARC논문는 스스로 '실험한 설정 안에서' 평가한 기준 방식보다 낫다고 밝혔다. 잔차 벡터 방법논문도 단일 사실 질문에서 성과를 보고했다. 여러 사실을 엮어야 하는 질문에서 어떻게 작동할지는 이 자료만으로는 알 수 없다.
더 공부하려면
평가 관점부터 잡으려면 100-LongBench논문를 먼저 읽고, '긴 문맥 능력'을 어떻게 떼어 재는지 이해하는 것이 좋다. 이어서 LURCH논문를 읽으면 근거의 흩어짐과 추론 깊이라는 틀로 'Lost in the Middle'류의 실패를 다시 볼 수 있다. Ref-Long논문은 찾기와 참조의 차이를 보여 주는 보충 자료다.
위치 인코딩 확장이 실제로 어떻게 쓰이는지 궁금하다면 긴 문맥 초안 모델 연구논문가 좋다. RoPE 위치 번호를 학습 범위로 되돌리는 아이디어와, 그것이 계산을 바꾸지 않는 조건을 구체적으로 다룬다. 서빙 비용 쪽은 TideKV논문를 이어서 읽으면 된다.
에이전트나 RAG를 설계한다면 ARC논문와 근거 기반 생성 진단 연구논문를 함께 읽기를 권한다. 무엇을 윈도 안에 두고 무엇을 바깥에 두었다가 불러올지라는 컨텍스트 엔지니어링의 질문에 서로 다른 답을 준다. 긴 창이 왜 도움이 되는지 이론적으로 보고 싶다면 시계열 연구논문가 짧고 명확하다.
관련 용어
참고 문헌
핵심 논문
- Long-Context Drafting Does Not Require Long-Context Drafters (2026)
- 100-LongBench: Are de facto Long-Context Benchmarks Literally Evaluating Long-Context Ability? (2025)
- Ref-Long: Benchmarking the Long-context Referencing Capability of Long-context Language Models (2025)
- Addressable Recall Compaction for Long Context-Window Control in AI Agents (2026)
- Residual Vector-based Reconstruction as Long-Context Recall Regardless of Context Window Size (2026)
- Why Do Time Series Models Need Long Context Windows? (2026)
- LLMs for Academic Workflows: An Evaluation of Literature Reviews Generated with Short and Long Context Windows of LLMs (2026)
최근 연구
- Beyond Context Length: Characterising the Difficulty of Long-Context Reasoning (2026)
- TideKV: Delayed KV Eviction via Layer-Wise Chunked Prefill for Memory-Efficient Long-Context LLM Inference (2026)
- The Bottleneck Is Retrieval, Not Reading: Diagnosing Evidence-Based Generation with RAG for Long Context Question Answering (2026)
AI가 참고 문헌을 바탕으로 작성하고 검수를 거친 해설입니다. 정확한 내용은 원문을 확인해 주세요.