주제 탐구 · 2026-10-28 · 기초 · 작성자 bombong
환각(Hallucination): 왜 생기고 어떻게 줄이나
환각은 언어 모델이 그럴듯하지만 틀린 말을 하는 현상으로, 학습과 평가가 '모른다'보다 '찍기'를 보상하기 때문에 생긴다는 설명이 힘을 얻고 있다. 이 글은 원인과 탐지·완화 기법, 최근 연구 흐름, 실무에서 기법을 고를 때 따질 점을 정리한다.
목차
- 환각은 이상한 버그가 아니라 사실과 오류를 구별하지 못하는 분류 오류에서 통계적으로 생기며, 정답만 채점하는 평가가 '찍기'를 부추긴다.
- 환각은 과제마다 성질이 다르다. 사실 질문은 모델 내부에서 비교적 잘 구분되지만, 요약이나 오개념이 많은 질문에서는 정답과 환각이 섞인다.
- 환각을 다루는 방법은 크게 세 가지다. 원인 쪽(채점·보상 바꾸기), 생성 쪽(RAG·투표·내부 조향), 사후 쪽(탐지·검증)이다.
- 최근 연구는 확신도와 정답이 맞아떨어지게 보상을 설계하는 방향, 그리고 에이전트의 도구 호출 환각을 실행 전에 막는 방향으로 넓어지고 있다.
- 탐지 점수는 벤치마크가 환각을 정의하는 방식에 따라 크게 달라진다. 숫자 하나만 보고 기법을 비교하면 안 된다.
왜 문제인가: 그럴듯하게 틀리는 모델
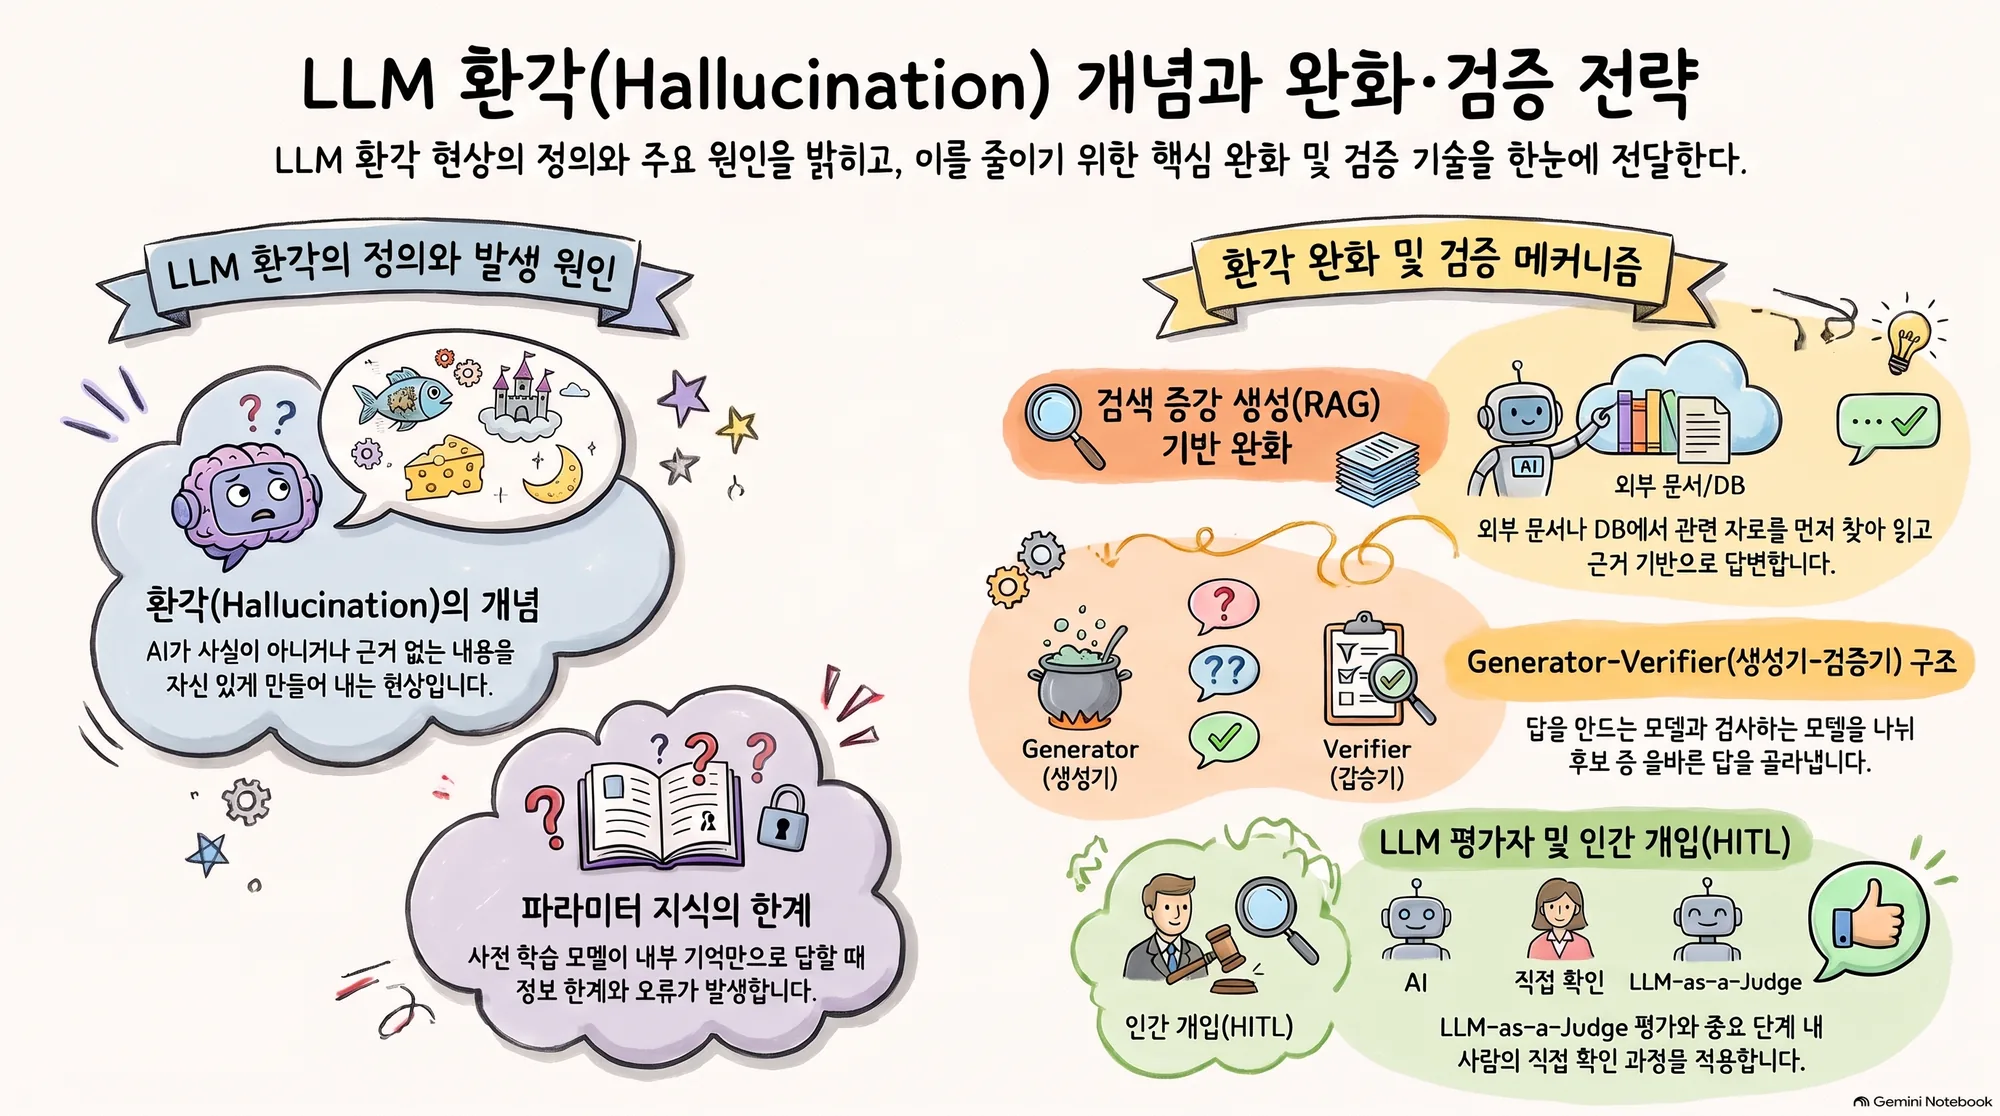
환각(Hallucination)은 대규모 언어 모델(LLM)이 유창하지만 사실과 다른 내용을 내놓는 현상이다. 문법이나 말투에는 문제가 없어서 읽는 사람이 오류를 알아차리기 어렵다. 그래서 단순한 성능 문제가 아니라 신뢰의 문제가 된다. 'Why Language Models Hallucinate논문'는 최신 시스템에서도 환각이 사라지지 않고 신뢰를 떨어뜨린다고 지적한다.
흔히 모델을 키우고 데이터를 늘리면 환각이 저절로 줄어들 것이라고 기대한다. 그러나 신경 다양성 연구논문는 파라미터·연산량·데이터가 늘어나도 언어 모델이 계속 환각을 낸다는 점을 출발점으로 삼는다. 규모만 키워서는 풀리지 않는 구조적 원인이 있다는 뜻이다.
외부 문서를 찾아 근거로 붙이는 RAG(검색 증강 생성)도 완전한 해법은 아니다. VOTE-RAG논문는 검색 결과 자체가 잘못되면 생성 모델이 거기에 끌려가 오류가 겹치는 '환각 위의 환각'이 생긴다고 설명한다. 근거를 붙여도 그 근거가 틀릴 수 있다는 점이 이 주제를 어렵게 만든다.
핵심 아이디어: 시험에서 찍는 학생
'Why Language Models Hallucinate논문'가 드는 비유는 어려운 시험 문제 앞에 선 학생이다. 빈칸으로 내면 0점이지만 찍으면 맞을 수도 있다. 그러니 모르는 문제라도 그럴듯한 답을 적는 편이 점수에 유리하다. 이 논문은 언어 모델도 같은 상황에 있다고 본다. 확신이 없을 때 '모르겠다'고 하기보다 그럴듯한 답을 추측하는 것이다.
이 설명에는 두 단계가 있다. 첫째, 사전학습 단계에서 환각은 신비한 현상이 아니라 이진 분류(맞다/틀리다를 가르는 문제)의 오류에서 생긴다. 틀린 문장과 사실을 구별할 수 없다면 자연스러운 통계적 압력만으로도 환각이 생긴다. 둘째, 대부분의 평가가 정답 여부만 채점한다. 그래서 모델은 '시험을 잘 보는 쪽', 즉 불확실할 때 찍는 쪽으로 최적화된다.
이 관점에서는 처방도 달라진다. 이 논문은 환각 전용 평가를 하나 더 만드는 것으로는 부족하다고 본다. 대신 리더보드를 장악한 기존 벤치마크의 채점 방식, 곧 불확실한 응답을 벌하는 방식을 고쳐야 한다고 주장하며, 이를 기술과 사회가 함께 풀어야 하는 완화책이라고 부른다. '왜 설계가 이렇게 됐나'라는 질문의 답이 모델 구조가 아니라 평가 제도에 있다는 것이 이 관점의 핵심이다.
어떻게 생기고 어디서 잡나
환각이 생기는 길을 단계로 나누면 대응 지점이 보인다. ① 사전학습에서 다음 토큰을 예측하며 통계를 익히는 동안, 구별하기 어려운 사실은 오류로 남는다. ② 평가·보상 단계에서 정답만 채점하면 추측이 보상을 받는다. ③ 답을 생성하는 순간, 모델 내부의 상태가 정답 쪽으로 갈지 환각 쪽으로 갈지 정해진다. ④ 출력이 나온 뒤에는 탐지·검증으로 걸러 낼 수 있다.
③단계를 들여다본 연구가 'Hallucination Basins논문'이다. 이 연구는 모델이 토큰을 하나씩 생성하며 지나가는 Hidden Representation의 Trajectory를 분석하고, 잠재 공간(모델 내부의 수치 공간)에 과제마다 다른 '분지(basin)', 즉 상태가 빨려 들어가는 움푹한 영역이 있다고 본다. 사실 질문에서는 정답과 환각의 분지가 비교적 뚜렷이 갈리지만, 요약이나 오개념이 많은 질문에서는 겹치는 경우가 많다. 이 기하 구조를 이용해 생성 방향을 살짝 틀면(조향) 재학습 없이 환각 확률을 낮출 수 있다고 보고한다.
④단계의 탐지는 접근법이 여럿이다. OOD 관점 연구논문는 다음 토큰 예측을 분류 문제로 보고, 컴퓨터 비전에서 쓰던 분포 밖(OOD, 학습 때 보지 못한 유형의 입력) 탐지 기법을 언어 모델에 맞게 고쳐 적용한다. 그 결과 학습이 필요 없고 샘플 하나로 판단하는 탐지기를 얻었으며, 추론 과제에서도 정확도가 높았다. 소형 모델 검증 연구논문는 답을 문장 단위로 나눈 뒤, 검색된 문맥을 보고 여러 SLM(소형 언어 모델)이 'Yes'라고 답할 확률을 모아 각 문장이 근거에 맞는지 판정한다.
생성 단계에서 아예 덜 틀리게 만드는 방법도 있다. VOTE-RAG논문는 여러 에이전트가 다양한 검색어로 문서를 모으는 '검색 투표'와, 여러 에이전트가 독립적으로 답한 뒤 다수결로 정하는 '응답 투표'를 두 단계로 둔다. 따로 학습할 필요가 없고 모든 과정을 병렬로 돌릴 수 있다.
발전 흐름: 원인·탐지·완화의 세 갈래
이번 자료의 출발점 논문들은 하나의 계보라기보다 같은 시기에 세 갈래로 나란히 움직였다. 첫 갈래는 원인 설명이다. 'Why Language Models Hallucinate논문'는 통계와 평가 제도로 환각을 설명했고, 'Hallucination Basins논문'는 모델 내부의 기하 구조로 설명하며 과제마다 구분하기 쉬운 정도가 다르다는 점을 정리했다.
둘째 갈래는 탐지다. 소형 모델 검증 연구논문는 질문·답변·문맥 100여 세트로 실험해, 정답 응답과 환각을 가르는 F1 점수(정밀도와 재현율의 조화 평균)를 10% 높였다고 보고했다. 환각 분류 프레임워크논문는 프롬프트 엔지니어링으로 여러 유형의 환각을 일부러 재현하고 임베딩 공간에서 군집으로 분석했다. 그 결과 정보 왜곡이 심한 환각일수록 정답 군집에서 멀리 떨어진다는 상관을 찾았고, 간단한 분류기로도 둘을 구별할 수 있다고 봤다. OOD 관점 연구논문는 기존 탐지기가 약했던 추론 과제로 탐지 범위를 넓혔다.
셋째 갈래는 완화다. VOTE-RAG논문는 6개 벤치마크에서 더 복잡한 프레임워크와 비슷하거나 더 나은 성능을 보였다. 단순한 투표 구조라서, 질문이 다른 방향으로 바뀌어 버리는 '문제 표류' 위험도 피한다. 신경 다양성 연구논문는 병렬로 둔 Representation들끼리 서로 덜 닮게 만드는 '신경 다양성'을 제안했다. 이를 구현한 ND-LoRA(병렬 LoRA 어댑터에 상관을 줄이는 정규화를 결합)는 일반 정확도를 유지하면서 환각을 최대 25.6%, 평균 14.6% 줄였다. 신경 상관이 0.1% 늘 때 환각이 3.8% 늘어나는 연관도 보고하며, 이를 파라미터·데이터와 별개인 '세 번째 스케일링 축'이라고 불렀다.
요즘 어디로 가고 있나
첫째 흐름은 '찍기를 보상하지 말라'는 진단을 학습 보상에 직접 넣는 것이다. CalibraRL논문은 정답에 보상하고 오답에 벌을 주며 기권(답하지 않기)도 허용하는 강화학습이 이미 쓰이고 있지만, 고정 보상으로는 확신에 찬 오답과 머뭇거린 오답을 구별하지 못한다고 지적한다. 그래서 답할 때는 확신도와 정답 여부가 어긋날수록 벌점을 주고, 기권할 때는 그 질문에서 모델이 얼마나 믿을 만하게 답하는지를 추정해 보상을 정한다. 학습 중 이미 생성한 Rollout을 재활용하므로 '모델이 이 답을 아는가'에 대한 추가 라벨이 필요 없다. 세 QA 데이터셋에서 답의 정밀도를 높이고 환각을 줄였다고 보고한다.
둘째 흐름은 환각의 범위가 글에서 행동으로 넓어진 것이다. StateMirror논문는 코딩 에이전트가 존재하지 않는 경로나 설치되지 않은 패키지를 호출하는 일을 '환각된 도구 사용'이라고 부른다. 4,398개 에이전트 Trajectory를 조사해 보니 이런 환각은 흔했고, 복구하는 데 중앙값 기준 3번의 추가 상호작용과 2만 2,400개(22.4K) 토큰이 들었다. StateMirror는 하네스 경계에서 행동을 가로채고, 실행 전에 실제 저장소 상태와 결정론적으로 대조한다. 2,508개 행동에서 정밀도 0.940, F1 0.817을 기록해 가장 강한 LLM 평가자보다 F1이 35.3% 높았다. 탐지 지연은 중앙값 17.73초에서 1.50ms로 줄었고 토큰은 쓰지 않았다. 실행 전에 받은 피드백으로 에이전트는 환각된 도구 호출의 95% 이상을 스스로 고쳤다.
셋째 흐름은 '탐지 점수를 어떻게 믿을 것인가'라는 측정 문제다. Mycelium논문은 벤치마크마다 환각을 정의하고 재는 방식이 크게 달라 점수끼리 비교하기 어렵다고 지적한다. 그래서 출처(출력과 근거를 어떻게 얻었나), 유형(사실성 실패인가 근거 충실성 실패인가), 단위(어느 범위에서 라벨을 붙이고 평가하나)라는 세 축으로 벤치마크를 정리했다. 구간 단위 평가에서는 라벨 경계가 조금만 달라도 점수가 크게 흔들린다는 점도 보였다.
StateMirror의 실행 전 검사
한계와 실무 판단 기준
가장 흔한 실수는 'RAG를 붙였으니 환각은 해결됐다'고 여기는 것이다. VOTE-RAG논문가 짚은 대로, 잘못된 검색 결과는 오히려 환각을 키운다. 검색 품질을 따로 점검하고, 검색어를 다양하게 하거나 여러 답을 비교하는 장치를 함께 두는 편이 안전하다.
둘째, 과제에 따라 기법이 잘 듣는 정도가 다르다. 'Hallucination Basins논문'에 따르면 사실 질문에서는 내부 신호로 환각을 가르기 쉽지만, 요약이나 오개념이 섞인 질문에서는 정답과 환각이 겹친다. 신경 다양성 연구논문도 과제마다 알맞은 다양성 정도가 다르다고 보고했다. 데모용 사실 질문에서 잘 되던 탐지기가 요약 업무에서도 잘 되리라고 가정하면 안 된다.
셋째, 탐지 성능 숫자를 그대로 비교하지 않는다. Mycelium논문이 보였듯 같은 '환각 탐지 F1'이라도 벤치마크가 무엇을 환각으로 보는지에 따라 의미가 다르다. 도입 전에는 우리 업무 데이터에서 '환각'을 어떤 단위(문장·구간·답 전체)와 유형으로 볼지 먼저 정하고, 그 기준으로 다시 재야 한다.
넷째, 기권과 정확도는 맞바꾸는 관계다. '모르면 모른다'를 허용하면 환각은 줄지만, 지나치면 쓸모없는 기권이 늘어난다. CalibraRL논문이 기권 보상을 질문별 신뢰도에 따라 조절하는 이유가 여기에 있다. 실무에서도 기권 비율과 오답 비율을 함께 보고, 서비스가 '틀린 답'과 '답 없음' 중 무엇을 더 싫어하는지 정해 두어야 한다. 아래 표는 이 글에서 다룬 기법을 재학습 필요 여부, 외부 근거 필요 여부, 모델 내부 접근 필요 여부로 나눈 것이다. API로만 모델을 쓴다면 내부 접근이 필요 없는 기법부터 검토하는 것이 현실적이다.
환각 대응 기법 고르기
| 재학습 없이 | 외부 근거 필요 | 모델 내부 접근 | |
|---|---|---|---|
| VOTE-RAG | ✓ | ✓ | ✕ |
| SLM 검증 | ✓ | ✓ | ✕ |
| OOD 탐지 | ✓ | ✕ | ✓ |
| 분지 조향 | ✓ | ✕ | ✓ |
| ND-LoRA | ✕ | ✕ | ✓ |
| CalibraRL | ✕ | ✕ | ✓ |
| StateMirror | ✓ | ✕ | ✕ |
더 공부하려면
처음이라면 'Why Language Models Hallucinate논문'부터 읽기를 권한다. 환각을 분류 오류와 평가 제도의 문제로 보는 시각을 잡아 두면 다른 논문들이 어느 단계를 겨냥하는지 정리하기 쉽다. 전체를 한 번 훑고 싶다면 환각의 종류·원인·완화법을 짧게 요약한 리뷰논문가 입문용으로 맞다.
모델 내부에서 무슨 일이 일어나는지 궁금하다면 'Hallucination Basins논문'와 OOD 관점 연구논문를 이어서 읽는다. RAG 서비스를 운영한다면 VOTE-RAG논문와 소형 모델 검증 연구논문가 바로 적용할 수 있는 학습 없는 방법을 보여 준다.
최신 흐름은 세 편이면 충분하다. 보상 설계 쪽은 CalibraRL논문, 에이전트 쪽은 StateMirror논문, 평가 방법론 쪽은 Mycelium논문을 읽는다. 특히 Mycelium은 다른 탐지 논문의 숫자를 읽는 법을 알려 주므로, 기법을 비교·도입하기 전에 먼저 보면 좋다.
관련 용어
참고 문헌
핵심 논문
- Why Language Models Hallucinate (2025)
- Hallucination Basins: A Dynamic Framework for Understanding and Controlling LLM Hallucinations (2026)
- From Out-of-Distribution Detection to Hallucination Detection: A Geometric View (2026)
- Hallucination Detection with Small Language Models (2025)
- A novel hallucination classification framework (2025)
- Mitigating Hallucination on Hallucination in RAG via Ensemble Voting (2026)
- Neural Diversity Regularizes Hallucinations in Language Models (2025)
최근 연구
AI가 참고 문헌을 바탕으로 작성하고 검수를 거친 해설입니다. 정확한 내용은 원문을 확인해 주세요.